Vane Data + Jev:构建端到端智能语音分析 Pipeline
客户来电咨询业务或反映问题,工作人员需要从录音里整理诉求,再交给对应的处理队列。除了听清内容,还要判断事情是否紧急、客户是否明显不满、有没有需要继续跟进的事项。逐条回听费时,客户表达含糊时还要反复确认。
把录音转成文字可以减少回听,分流的问题却没有解决。客户未必使用标准业务名称:“停止我卡上的所有交易”表达的是冻结请求,但整句话里没有“冻结”两个字。只按关键词匹配,规则没有覆盖的说法就会漏掉。对于完整通话,还要结合处理过程,区分已经解决的问题和尚未完成的请求。
本文以 demo-scene 仓库中的银行语音示例为例。decode_audio 和 transcriber() 的内部实现从略;完整代码和离线测试见文末链接。
背景:关键词分流不够用
只靠关键词分流,通常会在两处失效。第一是措辞:客户可能描述想要的结果,而不是业务名称。第二是状态:某个诉求在转写里出现过,但客服已经处理完成;把所有提及都当成未完成事项,会把工单送进错误的队列。因此,一条可用的流程需要读完整通对话,理解诉求,并判断哪些事项仍未解决。
基于 Vane Data + Jev 构建 Pipeline
Vane Data 是组织这条流水线的数据处理框架:每一步都写成一个算子,串成一份查询计划,统一调度,默认使用 Ray 执行。Relation 是算子之间传递数据的抽象——可以理解成一张“还没算出来的表”,上一阶段的输出直接成为下一阶段的输入,不需要中间文件。Jev 是其中负责语义判断的算子:它把转写文本发给外部模型,按预设问题取回结构化判断,模型不在本地运行。
Jev 由 TypeSafe AI 于 2026 年 9 月发布,官方定位是 System One,相当于 Agent 流程里的“智能 if 语句”。它不生成文本,输入可以是邮件、日志、转写文本这类非结构化状态,输出是类型化答案和置信概率。API 只有三种原语:Choice 选一个选项,Score 在给定尺度上打分,Noul 返回 0 到 1 的概率;本文的五个问题就用它们定义。
Jev 跳过了逐字生成,所有输出一次性并行给出。官方数据是端到端延迟 70–500 毫秒,部分任务上比前沿大模型快 193.6 倍,成本最低约为其 1/445(输入每百万 Token 0.042 美元,输出免费)。对客服分流这类高频判断,这个开销可以接受。
Jev 用自研的 RLCD(校准决策强化学习)训练,目标是让输出概率贴近实际准确率,程序可以直接拿概率和阈值比较。它不需要微调就能适应新的分类任务,本文的 14 类意图只靠问题定义给出,示例不训练模型。工单分流、内容审核、风险评级这类判断是它的典型场景。
下面用 PolyAI MInDS-14 的中文子集走一遍完整流程:CPU 负责音频解码,GPU 上的 Whisper 负责转写,Jev 负责结构化判断,SQL 负责把判断整理成业务字段。这几个阶段连接在同一条 Vane Relation 链上,由一份查询计划统一调度。
**典型流程:**Parquet 中文录音 → CPU 解码与重采样 → GPU Whisper 转写 → 质量检查 → Jev 结构化判断 → SQL 字段整理 → results.parquet / review.csv
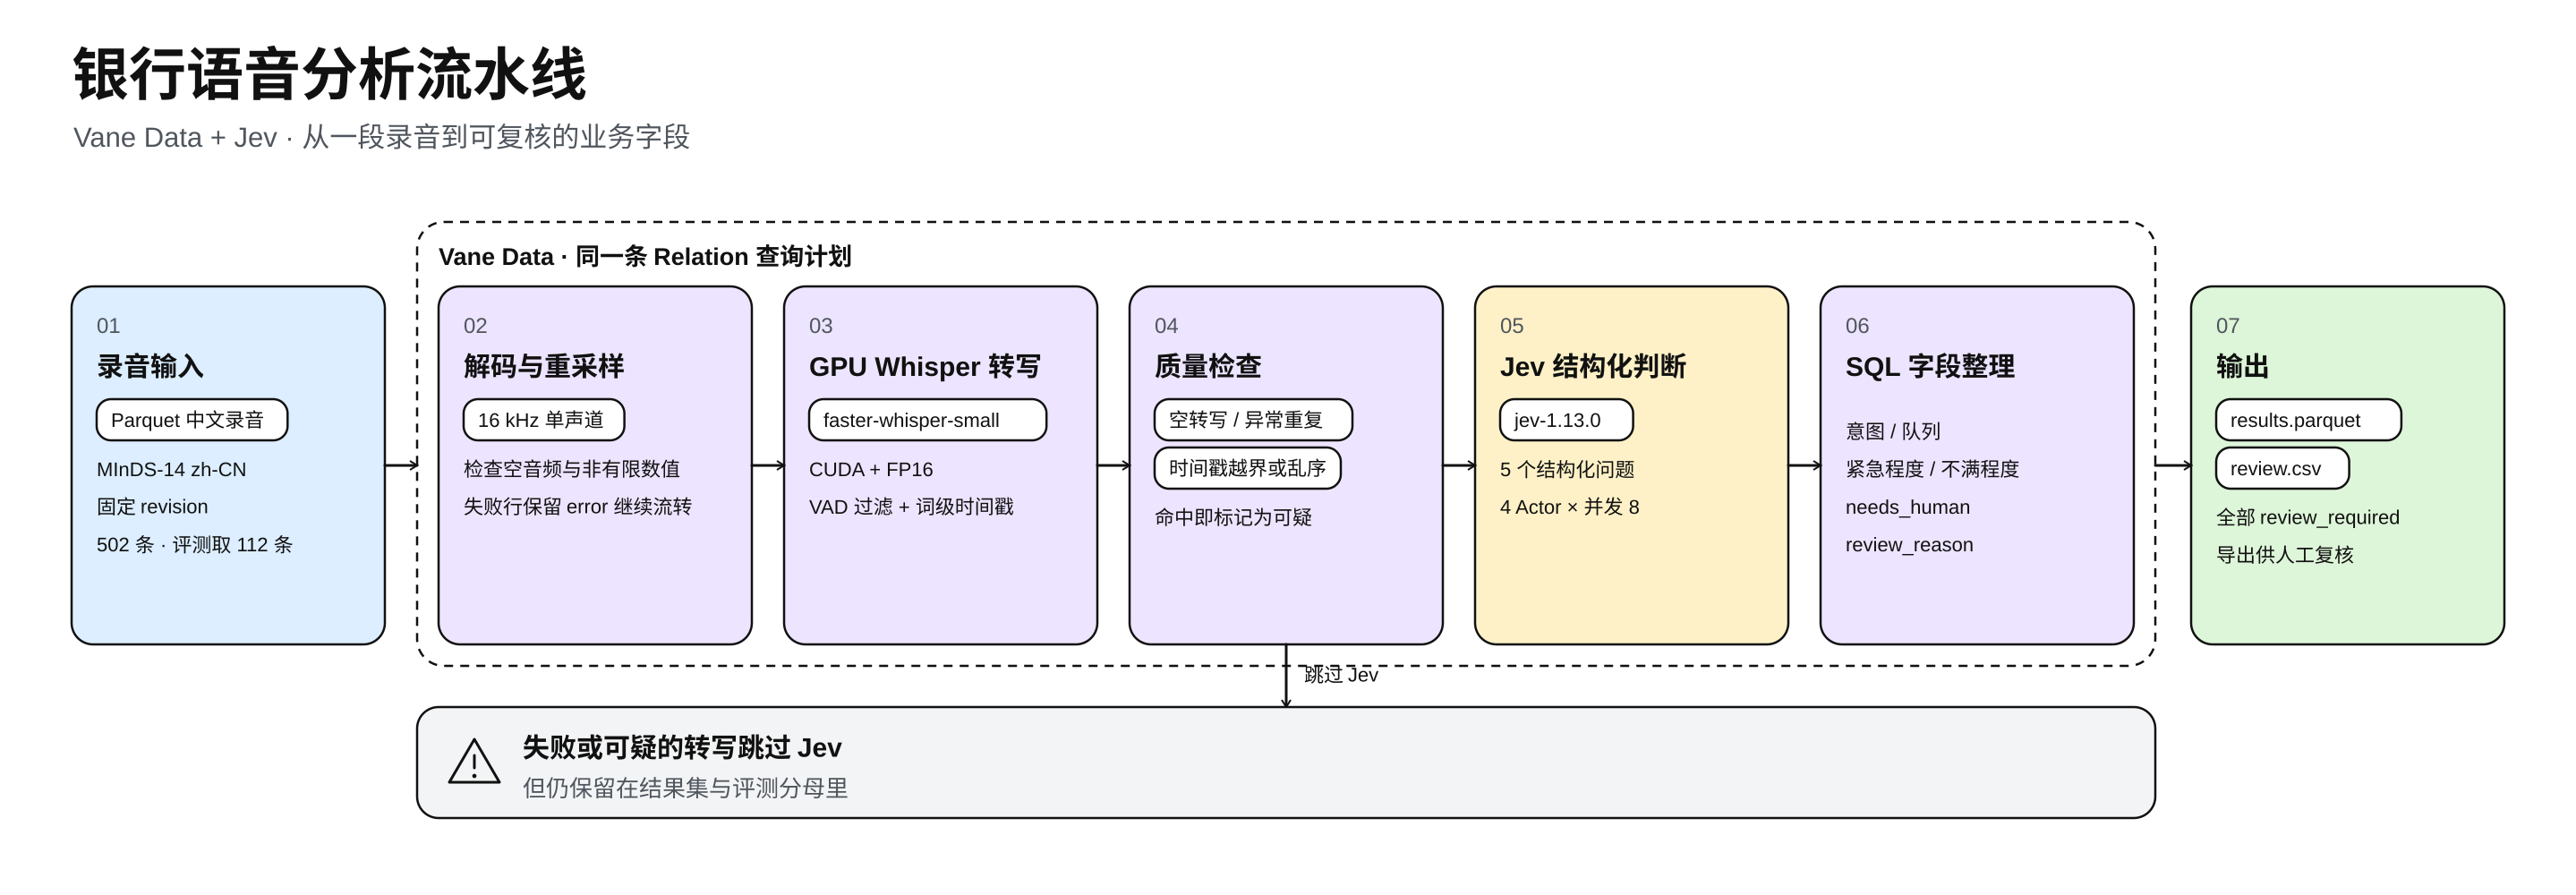
图里的工作分属三类计算资源。Vane 默认使用 Ray 执行:普通函数走 Task,可调用类和 Jev 走 Actor;Task 是一次性任务,Actor 是常驻的工作进程,可以在生命周期内复用模型和客户端。解码与重采样无状态,直接提交 CPU Task;Whisper 需要常驻显存复用模型,交给 GPU Actor;Jev 判断由外部 API 完成,本地执行器只负责组织请求、管理并发和接收结果,模型不在本地运行。
各阶段之间用 Relation 衔接:上一阶段的输出直接成为下一阶段的输入,不需要中间文件。流水线的产出是一组业务字段——意图 intent、建议队列 queue、紧急程度 urgency、不满程度 dissatisfaction、是否仍需人工跟进 needs_human,以及复核标记 review_required、review_reason。示例把所有结果标记为需要人工复核,并导出 review.csv;它没有接入复核系统,也不会直接触发冻结、转账等业务操作。
第一步:先把音频变成可检查的文本
用 SQL 选择数据
示例从 Parquet 读取音频(每行包含录音路径 path、语言 ID lang_id 和音频字节 audio.bytes),并根据录音路径的 SHA-256 值生成 record_id,按 ID 排序后取固定数量。raw 是 con.read_parquet(dataset) 读入的 Relation,dataset 是固定 revision 的 MInDS-14 中文子集文件,limit 来自命令行参数:
source = (
    raw.select(
        vane.sql_expr("sha256(path)").alias("record_id"),
        vane.sql_expr("CASE WHEN lang_id = 13 THEN audio.bytes ELSE error('Expected zh-CN') END").alias("audio_bytes"),
    )
    .order("record_id")
    .limit(limit)
)
这个 ID 贯穿后续流程:解码、转写、业务判断和评测都靠它对应同一条记录。进入推理的只有记录 ID 和音频字节,真实意图标签不参与,只在结果保存后读取用于评测。
在 CPU 上完成解码与重采样
录音文件里的压缩音频不能直接当成波形使用。CPU 阶段先检查音频是否只有一个单声道音轨,再解码为 16 kHz 波形,同时检查空音频和非有限数值。这些工作封装在 decode_audio 中,主线只是一条 map_batches 调用,加上输出结构声明:
audio = source.map_batches(
    decode_audio,  # 内部实现从略
    schema={
        "record_id": vane.sqltypes.VARCHAR,
        "waveform": vane.list_type(vane.sqltypes.FLOAT),
        "error": vane.sqltypes.VARCHAR,
    },
    batch_size=BATCH_SIZE,
)
这里有一个值得保留的工程设计:遇到解码异常时,记录不会直接消失,而是带着 error 字段继续进入后续流程。最终结果不仅包含成功处理的录音,也保留了需要检查的记录。
在 GPU Actor 中复用 Whisper 模型
波形数据随后交给 Whisper。示例使用 faster-whisper-small(model_path 是按固定 revision 下载好的模型目录),在 Actor 初始化时加载模型并配置 CUDA 和 FP16;转写时指定中文,开启 VAD 过滤和词级时间戳。模型加载与单条处理分开,同一个 Actor 就能复用已加载的模型。这些细节在 transcriber() 返回的可调用类内部,主线只声明输出结构和资源:
transcripts = audio.map_batches(
    transcriber(model_path),  # 内部实现从略
    schema={
        "record_id": vane.sqltypes.VARCHAR,
        "text": vane.sqltypes.VARCHAR,
        "segments": vane.sqltype(
            "STRUCT(role VARCHAR, start_ms BIGINT, "
            "end_ms BIGINT, text VARCHAR)[]"
        ),
        "baseline_intent": vane.sqltypes.VARCHAR,
        "error": vane.sqltypes.VARCHAR,
    },
    batch_size=BATCH_SIZE,
    actor_number=1,
    gpus=1.0,
)
这段代码明确了输入处理方式、输出结构,以及 GPU 资源要求。BATCH_SIZE 默认 128,可用环境变量覆盖,指 Vane 交给 UDF 的记录批量;Whisper 并不会同时对 128 条音频做 GPU 批量推理,它仍在批次内部逐条调用 model.transcribe()。数据处理批次和模型内部的推理批次是两个概念。
不把所有转写都当成有效输入
示例会检查空转写、异常重复文本、超出录音范围的时间戳和时间戳顺序。这些检查拦的是明显异常,不能证明转写完全正确,但可以避免在有问题的文本上继续生成业务建议;失败或可疑的记录不会进入业务判断,后面的 state() 会为它们返回 NULL。
第二步:用明确的问题,得到结构化业务判断
转写文本不能直接当业务字段用:自由格式的总结没有固定字段,取值也不稳定。示例把需要判断的内容拆成五个问题,分别是客户要办什么业务、事情有多紧急、客户是否表达不满、是否还需要人工跟进、转写是否足够清楚,并为每个取值划出边界。意图边界写在 INTENTS 里,五个问题用 Choice、Score 和 Noul 定义。
先固定意图边界
INTENTS 的每一项包含业务定义、处理队列和供关键词基线使用的词表:
INTENTS = {
    # 意图: (业务定义, 处理队列, 关键词基线)
    "card_issues": ("银行卡不能付款、取款或其他使用故障,不包括主动冻结。", "cards", ("刷不了", "卡失效", "卡不能用")),
    "freeze": ("冻结或阻止丢失、被盗或有风险的银行卡或账户,停止其交易。", "card_security", ("冻结", "挂失")),
    "pay_bill": ("主动支付账单或询问如何缴费,不包括自动扣款授权。", "payments", ("账单", "缴费")),
    # 其余 11 类从略
}
“银行卡无法付款”和“主动要求冻结银行卡”是两类意图;“主动支付账单”和“商家自动扣款授权”也分开处理。这些边界不写清楚,模型和关键词都会在相近的表达上摇摆。
再定义五个问题
问题用 Choice、Score 和 Noul 定义:意图是单选,紧急程度和不满程度是 0 到 4 的分档,剩余两个是是否判断。下面给出意图和两个分档问题的定义:
def questions():
    from typesafe_sdk import Choice, Noul, Score


    return {
        "intent": Choice(
            instructions="根据 conversation 判断 caller 的主要银行业务诉求,包括已解决的原始诉求。结合客服上下文,但不要把客服无关发言当作客户请求。信息不足选 other。",
            criteria={**{name: spec[0] for name, spec in INTENTS.items()}, "other": "其他业务或信息不足。"},
        ),
        "urgency": Score(
            instructions="在 analysis_time 时,客户尚未解决的事项有多紧急?已完成的操作不算待办,不臆测损失或期限。",
            criteria=[
                "事项已解决,或仅作一般咨询,没有未完成的紧急事项。",
                "常规请求未完成,可按正常周期处理,没有迫近期限。",
                "客户明确需要尽快处理,或正常业务受影响,但无即时损失风险。",
                "有明确的当天期限或严重业务阻断,需要优先处理。",
                "仍有盗刷、账户被盗或资金继续损失的即时风险,需立即介入。",
            ],
        ),
        "dissatisfaction": Score(
            instructions="仅依据 caller 的文字表达判断不满,不推断音调,也不把问题严重性当作不满。",
            criteria=[
                "中性或礼貌咨询,没有表达不满。",
                "表达轻微困惑、不便或担忧,没有抱怨服务。",
                "明确表达失望、抱怨或对处理不满。",
                "反复或强烈抱怨,对服务明显愤怒。",
                "表达极端愤怒、辱骂,或因服务问题威胁投诉、曝光、销户。",
            ],
        ),
        # needs_human / input_sufficient 两个是否问题的定义见正文说明。
    }
紧急程度只评估尚未解决的事项,不满程度只看文字表达、不推断音调。Score 分档从 0 开始,SQL 里统一加 1,输出为业务更常见的 1~5 档。另外两个问题,一个判断是否仍需人工跟进(无人回答、未办理或未完成的跟进为是,已解决的不计入),一个判断转写是否足够清楚(残缺、矛盾或无法理解时为否)。这组问题按完整通话设计,而 MInDS-14 只有客户单句,实际覆盖范围见评测一节。
构造请求并调用 Jev
接下来决定把哪些数据交给 Jev。state() 只构造语言、分析时点和转写片段,其中 analysis_time 取通话结束后,作为判断“尚未解决”事项的参考时点;失败的行在这里返回 NULL,跳过判断:
def state():
    # NULL 会让该行跳过 Jev;只有 error 为空的行才构造请求。
    return vane.sql_expr("""CASE WHEN error IS NULL THEN struct_pack(
        language := 'zh-CN', analysis_time := 'after_message_or_call_end', conversation := segments
    ) END""")
原始音频和真实标签不会发送给外部服务。不过,限定字段不等于脱敏:转写文本仍可能包含个人信息。
接入 Jev 只需要一次 Relation 调用:
judged = transcripts.jev(
    state(),
    questions=questions(),
    model=JEV_MODEL,          # 模型版本 "jev-1.13.0"
    actor_number=4,
    max_concurrency_per_actor=8,
)
actor_number 声明处理 Jev 请求的 Actor 数量,max_concurrency_per_actor 是每个 Actor 的在途请求上限;它们只描述请求侧并发,不代表实测吞吐。
Jev 调用是怎么执行的
构建表达式时只登记问题定义、模型和凭据,不发起请求;它生成的是计划里的一个处理步骤,和前面的解码、转写挂在同一条 Relation 上。请求组织、并发控制和结果对齐都由执行层完成,整个调用分为构建计划、执行调用、写回结果三段。
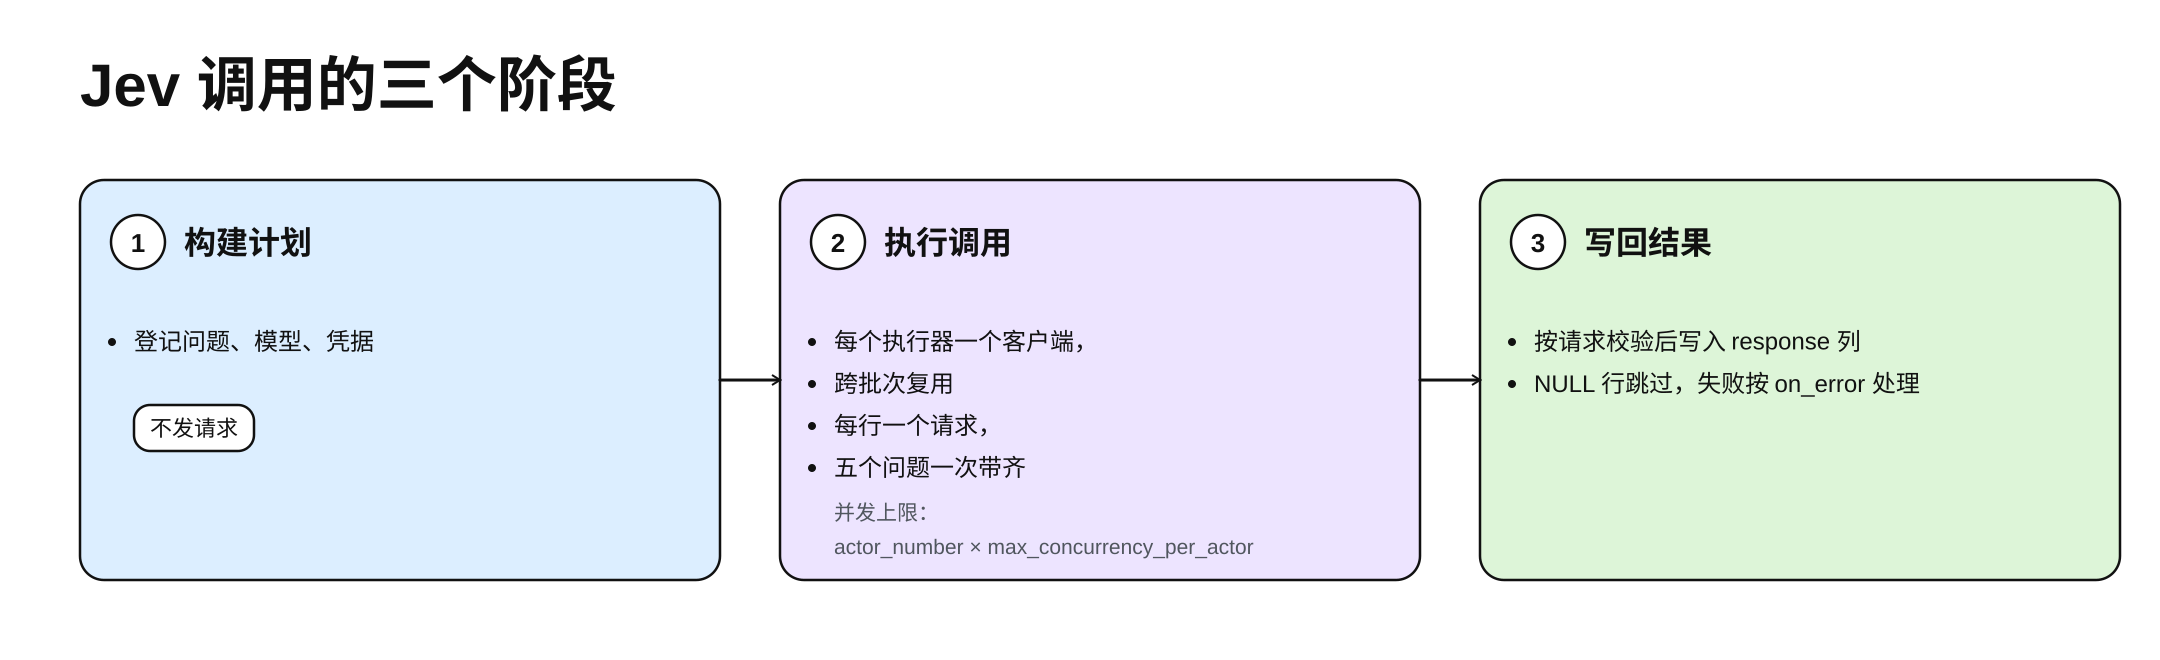
执行时,每个执行器持有一个可复用的客户端,跨批次复用;同一批数据里,每个非 NULL 行各发一个请求,五个问题一次带齐。
服务返回的 JSON 会先按请求校验一遍,再写进 response 列;NULL 行不发请求,失败行按 on_error 抛错或置为 NULL。同样的执行和校验逻辑在 SQL 侧对应 ai_jev。
Vane 对 Jev 的支持目前只发布在 TestPyPI 的 vane-ai dev 构建上,可以抢先使用,直接安装这个版本,就能在自己的项目里调用 Relation.jev():
pip install --index-url https://test.pypi.org/simple/ --extra-index-url https://pypi.org/simple/ "vane-ai[typesafe]==0.3.0.dev8"第三步:用 SQL 连接模型输出和业务数据
Jev 把结果写进 response 列。业务使用者需要的是一张字段稳定、含义清楚的表,因此在同一条流水线里执行 SQL,把 JSON 提取成业务字段,并按转写质量和输入充分性给出复核原因。字段大多是同样的 JSON 取值,这里只保留需要判断的几处(query() 的第一个参数是输入 Relation 名,SQL 里用 FROM judged 引用):
result = judged.query(
    "judged",
    f"""
    SELECT record_id, text, segments, error, baseline_intent,
        CASE WHEN response IS NULL OR (response ->> '$.model') = '{JEV_MODEL}'
             THEN response ->> '$.answers.intent.choice'
             ELSE error('Unexpected Jev model version') END AS intent,
        (response ->> '$.answers.urgency.score')::DOUBLE + 1 AS urgency,
        (response ->> '$.answers.needs_human.noul')::DOUBLE AS needs_human_probability,
        needs_human_probability >= 0.5 AS needs_human,
        CASE WHEN error IS NOT NULL THEN 'transcript_requires_review'
             WHEN (response ->> '$.answers.input_sufficient.noul')::DOUBLE < 0.5 THEN 'insufficient_input'
             ELSE 'manual_confirmation' END AS review_reason
    FROM judged
    """,
)
intent_confidence、dissatisfaction、input_sufficient_probability 等字段同样由 JSON 取值或加 1,完整 SQL 见源码。这几行里做了四件事:校验返回的模型版本,把 0 到 4 的分数映射成 1~5,用 0.5 阈值把概率转成 needs_human,再按转写错误和输入充分性给出 review_reason。DuckDB 允许同一层 SELECT 引用前面定义的别名,所以 needs_human_probability 可以直接在下一行复用。
最终输出字段包括:
| 字段 | 业务含义 |
|---|---|
| intent、queue | 客户诉求及建议处理队列 |
| urgency、dissatisfaction | 尚未解决事项的紧急程度、文字表达中的不满程度 |
| needs_human | 是否仍有需要工作人员处理、核实或回复的事项 |
| review_required、review_reason | 是否需要复核,以及复核原因 |
needs_human 和 review_required 容易混淆:前者指客户还有没有待办,后者指模型结论要不要人看。一条录音可能被判断为“没有后续人工需求”,但这条判断本身仍要复核,所以示例把所有记录的 review_required 都置为 true。
队列映射用同一份 INTENTS 生成 CASE:意图在 14 类里时映射到处理队列,其余保持原值。最后写出 results.parquet,review.csv 和评测都读这份结果,不会重跑 Whisper 和 Jev。
Jev 接进查询计划:省掉了哪些工作
把 Jev 做成 Relation 上的一个算子,省下的主要是模型调用之外的工程量:
- 客户端与并发:不用自己写请求循环、连接池、信号量和重试。Actor 数量与并发上限由配置声明,SDK 客户端在执行时按执行器创建并跨批次复用,并发在执行器本地受限。
- 请求组织与行对齐:每个非空行只发一次请求,一次带齐五个问题;返回的 JSON 作为新列拼回原行,后续 SQL 直接引用,不需要人工对账。
- 失败隔离与统一调度:state() 让失败或可疑的转写跳过外部调用,同时保留在结果集里;转写片段直接流入 Jev 再进入 SQL,CPU Task、GPU Actor 和 Jev Actor 在同一条计划里,批次、重试和数据搬运由执行层处理,只有最终结果写出 results.parquet 和 review.csv。
这些收益的前提是接受它的边界:Jev 是外部服务,转写文本会离开本地;结果只用于人工复核,不直接触发业务操作。
评测:口径与边界
这个示例使用 PolyAI MInDS-14 的中文子集。源数据提供 502 条录音,只有名为 train 的划分;示例不训练模型,是按录音路径哈希排序,默认选择其中 112 条进行固定子集评测。每条录音是客户的一段短表达,不是完整的多轮客服电话。
评测比较两种方法:一种在 Whisper 转写结果上匹配关键词,另一种让 Jev 根据同样的转写结果判断意图。因此,两种方法共享相同的录音输入和语音识别结果。关键词方法只在存在唯一最高分匹配时返回相应意图,否则返回 other。
| 指标 | 回答的问题 |
|---|---|
| 意图准确率 | 有多少录音被分到了正确的业务意图 |
| 14 类意图的宏平均 F1 | 每类分别计算 F1 后取平均 |
| 队列准确率 | 细分意图不同时,是否仍进入正确的处理队列 |
意图准确率和队列准确率分开计算,是因为不同意图可能映射到同一个处理队列:分类不够精确,分流仍可能正确。
另一个重要的细节是,**失败记录仍然计入评测分母。**代码会检查最终记录数量和 ID 集合是否与最初选中的一致;只看成功返回的部分,一个频繁失败的流程也可能得到好看的准确率。
示例不附带实测成绩,因此不能据此宣称 Jev 比关键词方法提升了多少,也不能给出吞吐或成本收益的结论。固定子集曾用于开发,且无法确认这些录音是否与上游模型训练数据重叠,不能当作严格独立的测试集;紧急程度、不满程度和人工跟进判断没有真实标签,needs_human 使用的 0.5 阈值也未经校准。
流水线输出的是字段,不直接触发任何业务操作:所有结果都带 review_required,并导出到 review.csv 供人工复核。示例处理的是单段短录音,转写片段统一标记为 caller,没有实现说话人分离,也没有验证完整多轮通话的分析能力。
真正可复用的是组织方式:Whisper 把声音变成文字,Jev 围绕明确的问题产出结构化判断,SQL 把判断整理成业务字段,Vane 把这些阶段和资源声明放进同一条计划。模型调用只是其中一步——前面有数据准备,中间有质量检查,后面有字段整理、结果保存、评测,以及供人工复核的 CSV。一段录音由此成为可追踪、可复核的数据,而不只是一次模型请求。
运行示例
示例的运行环境为 Python 3.12、uv 和一块 CUDA GPU,Vane 和 TypeSafe SDK 需要单独安装(其他环境选项见安装指南):
uv venv --python 3.12 .venv
source .venv/bin/activate
uv pip install --index-strategy unsafe-best-match \
  --index-url https://test.pypi.org/simple/ \
  --extra-index-url https://pypi.org/simple/ \
  'vane-ai[typesafe]==0.3.0.dev8' 'typesafe-sdk==0.7.0'
uv pip install -r requirements.txt
设置 TYPESAFE_API_KEY 后,从示例目录运行:
export TYPESAFE_API_KEY="your-api-key"
.venv/bin/python src/banking_voice_pipeline.py \
  --output-dir output/banking_voice_pipeline \
  --limit 112
输出目录必须是新目录。运行会下载固定 revision 的 MInDS-14 中文子集和 faster-whisper-small,结束时打印关键词基线与 Jev 的意图指标;CUDA 环境需要把 cuBLAS 12 和 cuDNN 9 加入 LD_LIBRARY_PATH。完整代码和离线测试见 banking-voice-pipeline。
让数据处理承载更多业务理解
Vane Data+Jev 展示了一种方向:让数据处理流程承载更多业务理解,让更多数据有机会转化为可用的判断与行动依据。当数据中包含人的表达、诉求和上下文时,业务价值往往需要经过理解与判断才能被提取出来。Vane Data 与 Jev 的结合,让这类判断能够成为数据处理流程的一部分:数据经过整理和计算,也能依据业务定义形成可供分析与使用的结果。
这为数据系统打开了更广的应用空间。随着业务问题变化,同一套处理方式可以承载新的判断维度,将分散在非结构化内容中的信息带入日常分析与决策。数据工程与业务理解由此有了更直接的连接。
本文的银行语音案例只是一个起点。更值得继续探索的是:如何让语义判断像其他数据操作一样被组织、组合和验证,使数据系统能够回应更多过去难以用固定规则描述的业务问题。