GPT-6 Astra 之后:如何高效进行多模态自动标注
更强的模型降低了多模态自动标注的门槛。本文以体育视频为例,介绍 Vane Data 如何串联数据准备、自部署推理、外部 API 和结果校验,在既定资源下产出更多合格标签。
GPT-6 Astra 降低了自动标注门槛
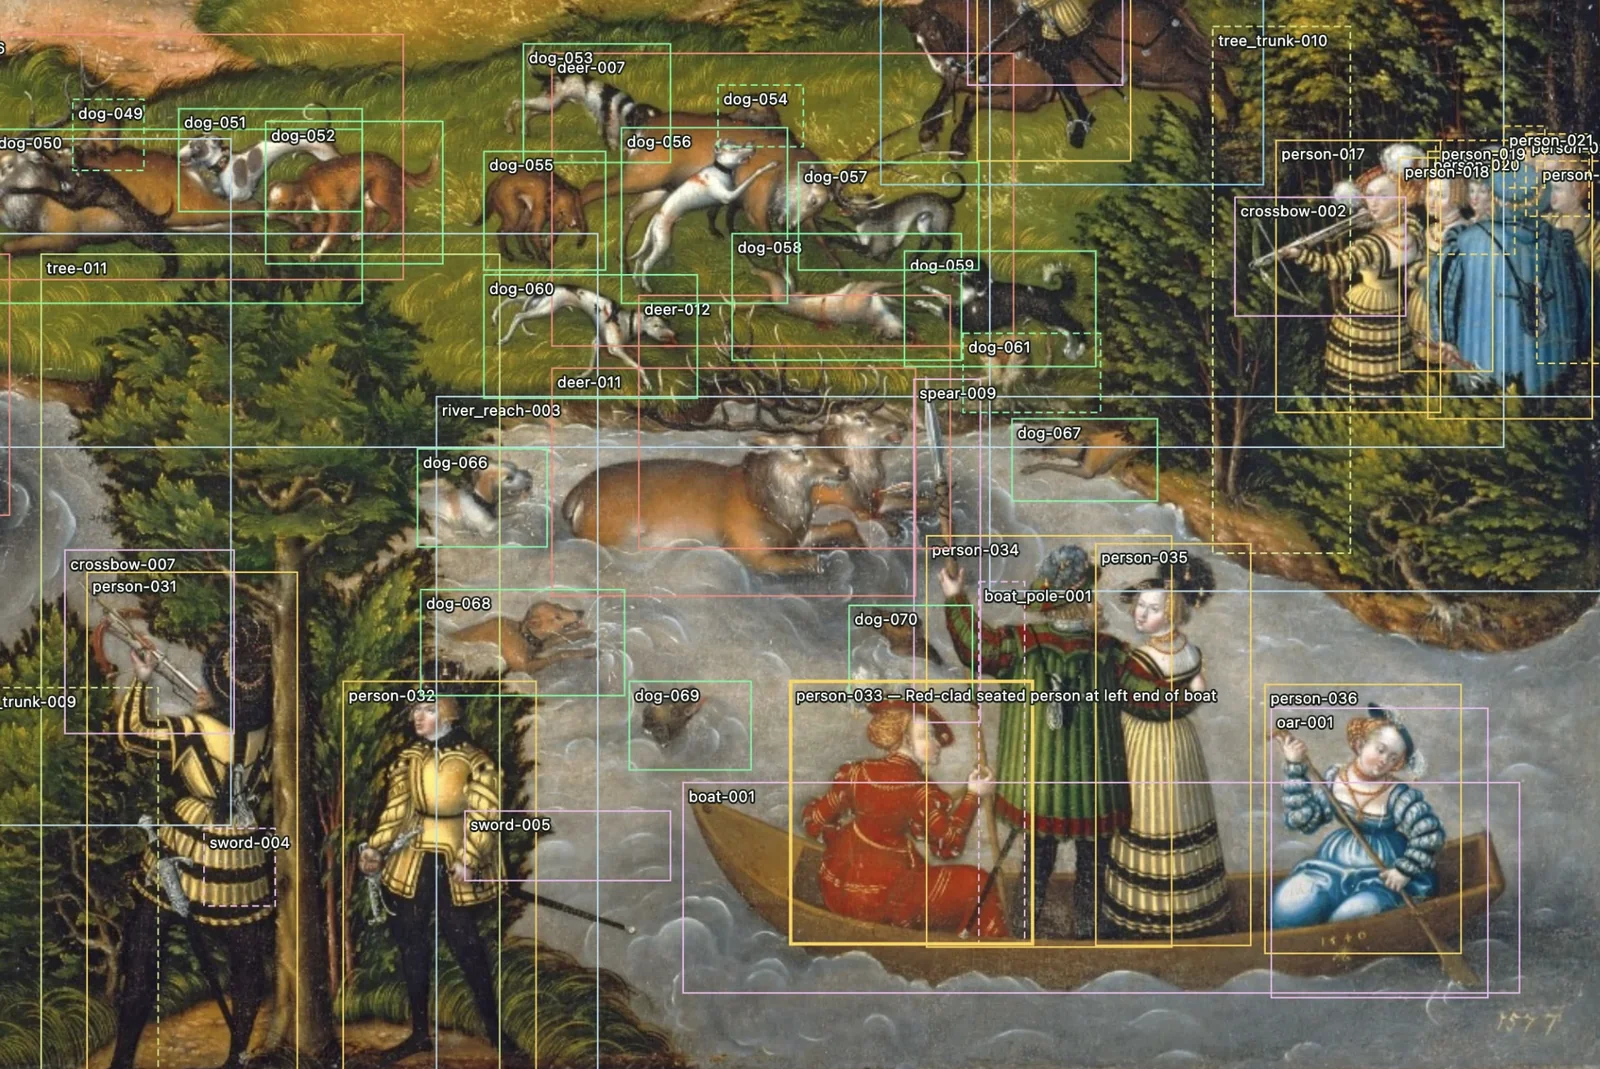
在 Deep Label 实验 中,GPT-6 Astra 为一幅艺术作品中的重要对象添加标签。此前,作者曾花费不少时间搭建从作品标注到网页展示的工作流;这一次,给出初始提示后,模型便自主开展标注,再经后续审查修正部分错误,最后生成了一个可交互查看标注结果的网页。
标注效率越来越重要
这个实验展示了单次标注任务可以如何完成。但当团队需要持续处理大量数据时,还要考虑整条流程的执行效率。以不断新增的体育视频为例,除了模型标注,还需要持续提供输入、协调本地推理与外部 API,并完成结果校验、来源关联和写回。Vane Data 面向的,正是这条多模态数据流水线的执行问题。目标很明确:在既定资源下,产出更多合格标签。
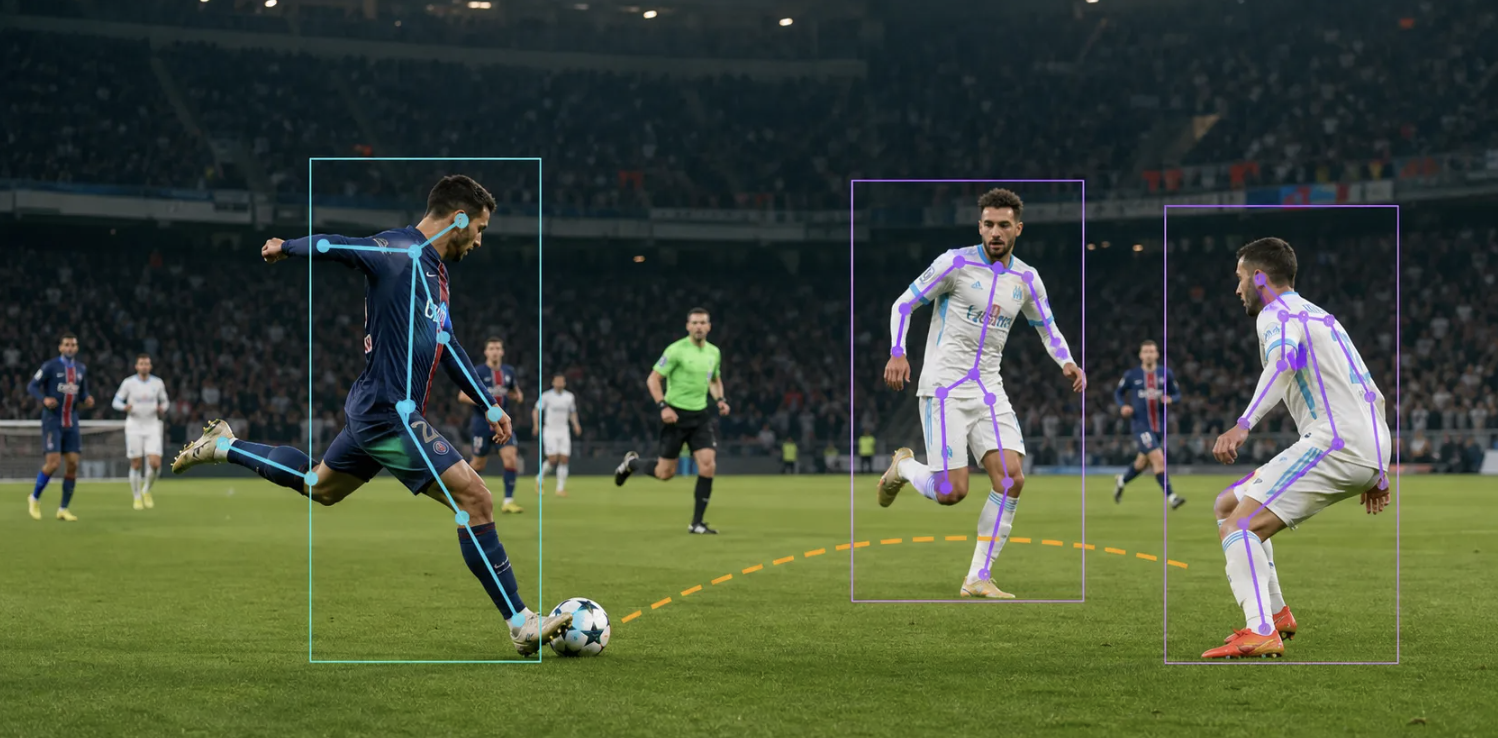
自动标注门槛降低后,团队可能从精选片段扩展到更多比赛和训练录像。同一段视频还可以用于球员识别、球队判断、动作分类和场景描述。标注工作量既取决于视频数量,也取决于需要生成的标签种类,不同任务的标注质量需要分别评估。
新视频持续进入,分类规则或输出格式的变化又可能触发历史数据重标。自动标注也随之从一次性任务,逐步转向持续运行、反复迭代的数据流程。随着处理范围扩大、标签维度增加、更新频率提高,团队需要在有限的 GPU、显存、API 配额和预算下,同时考虑模型选择、处理吞吐,以及校验、复核和重跑的开销。
从模型选择到标注流水线设计
根据任务与质量要求选择模型
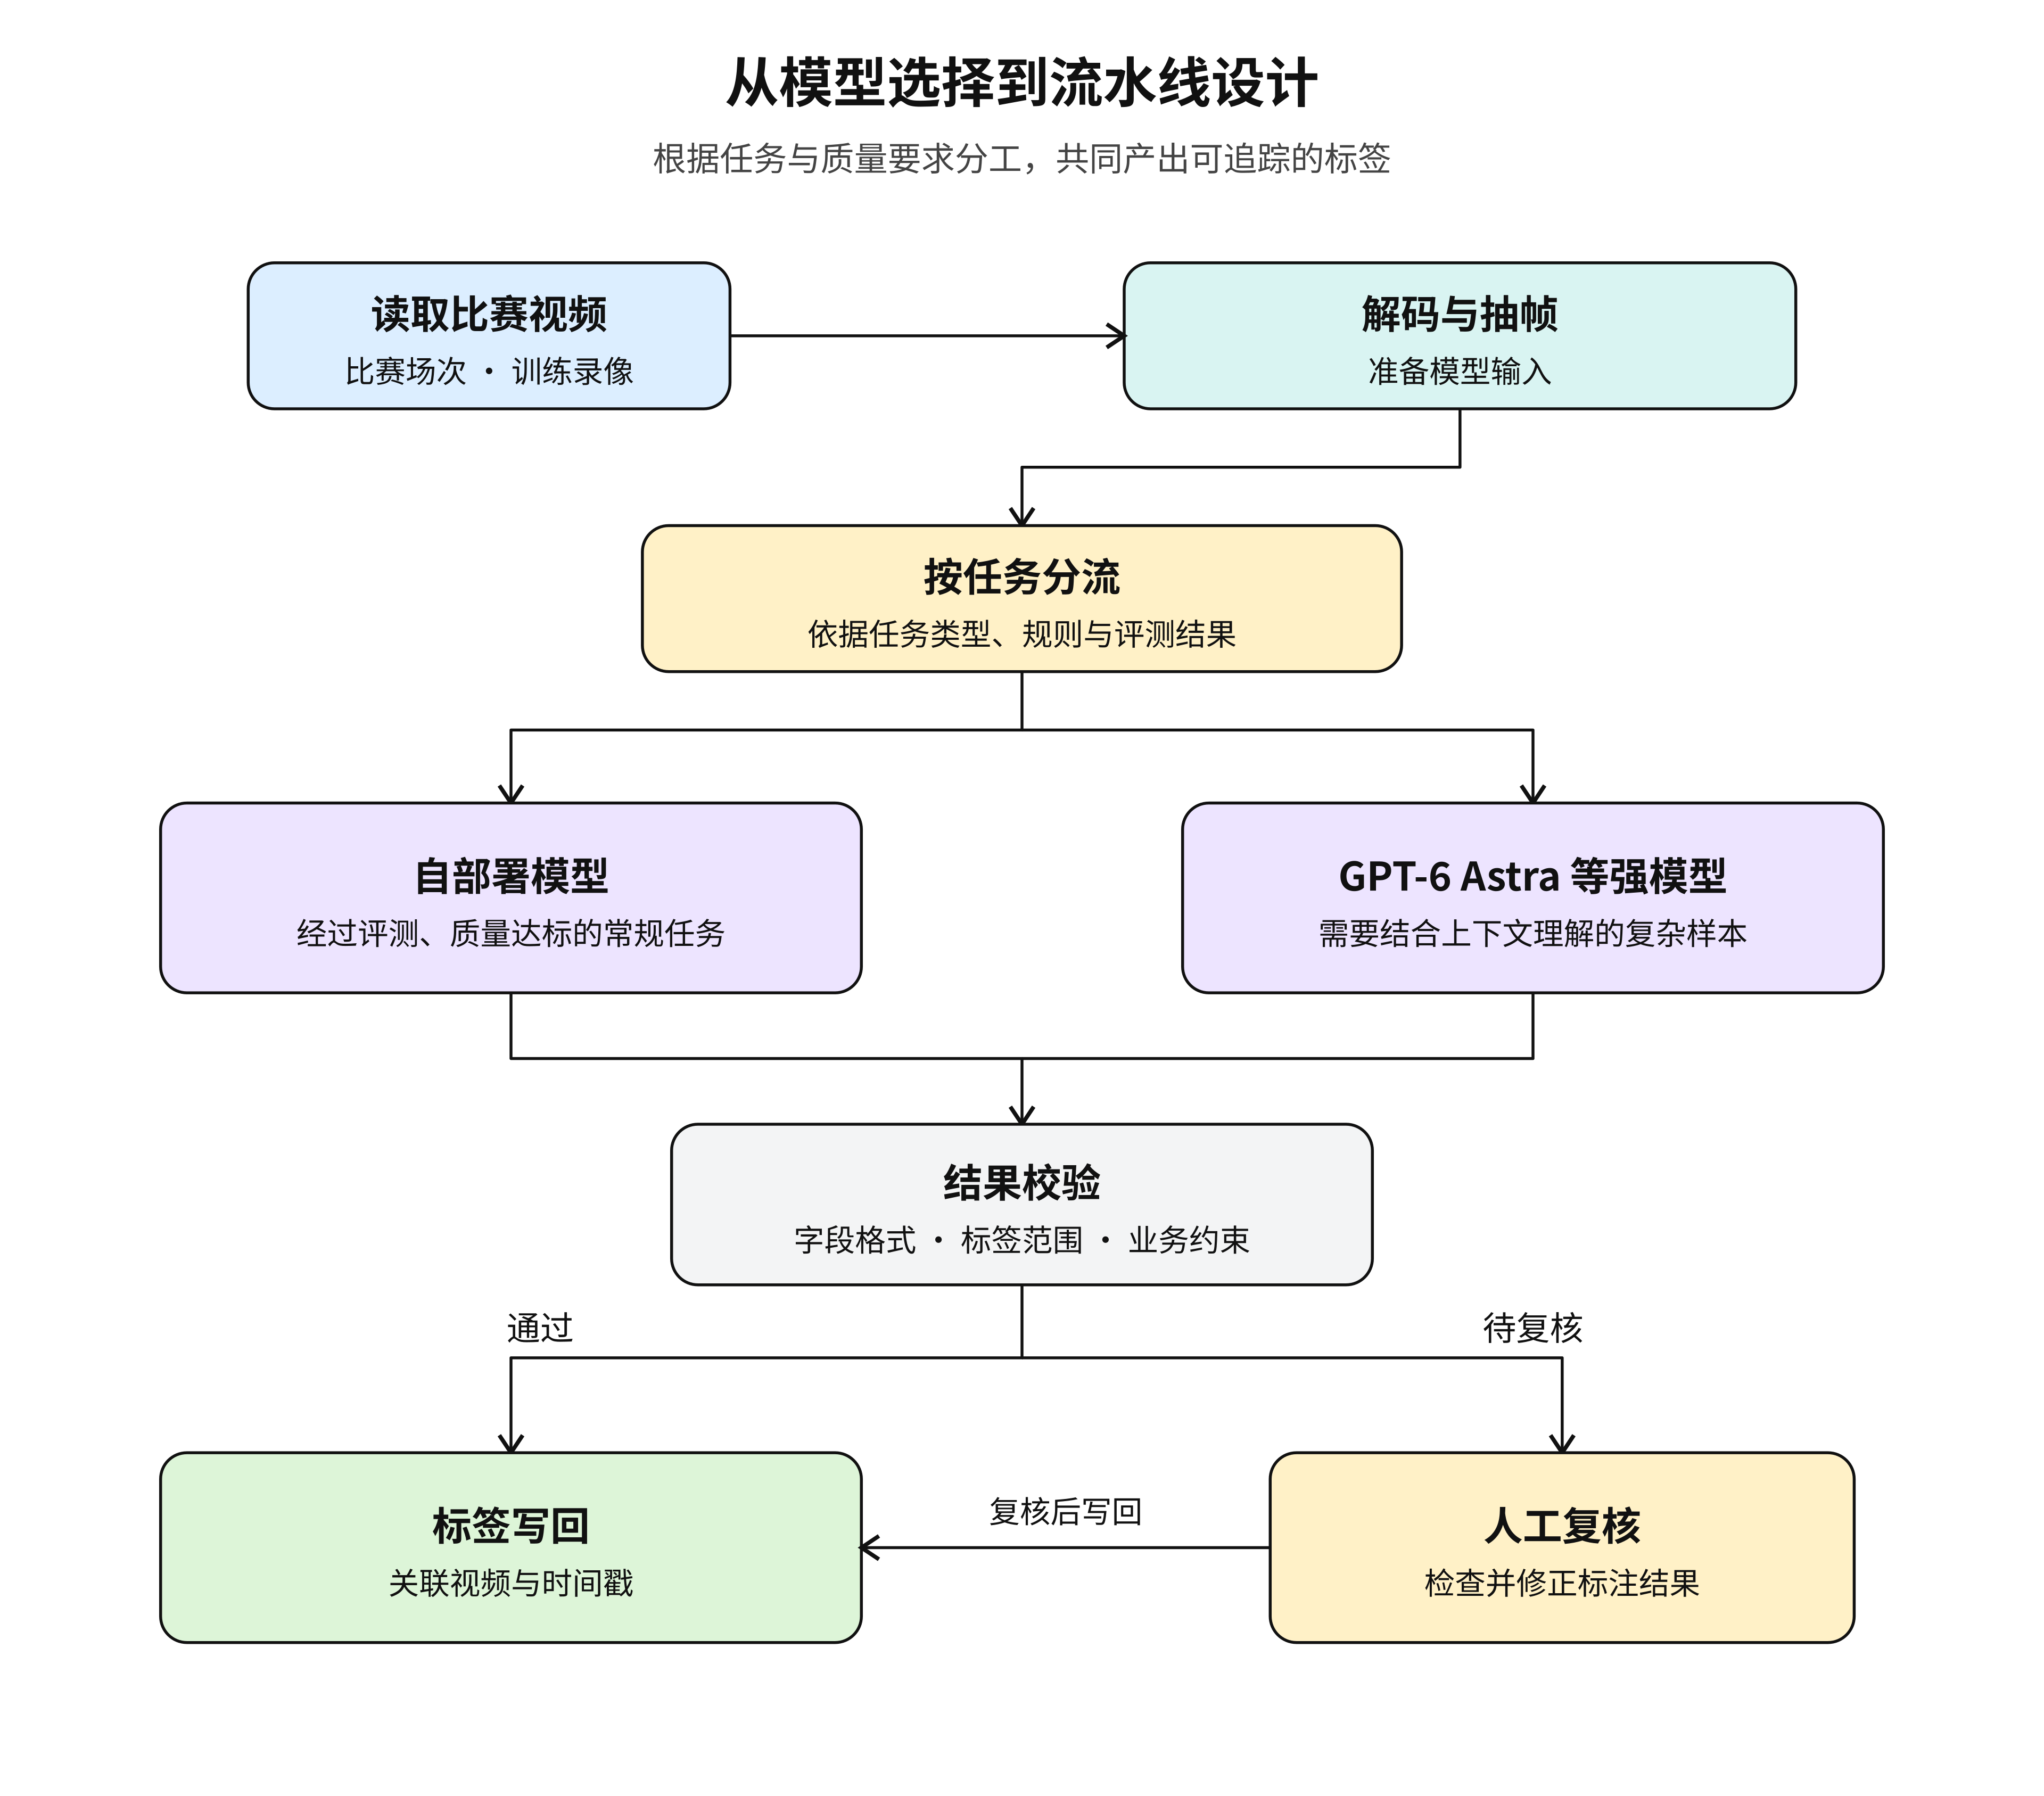
对于前面的体育视频标注任务,可以根据质量要求分配模型。在常规识别任务上,如果自部署模型经评测已达到要求,就可以用它批量处理;需要结合上下文理解的复杂样本,可以调用 GPT-6 Astra 等强模型;无法可靠判断的结果,则进入人工复核。分流可以依据任务类型、规则校验或模型间分歧,分流规则需要用带有人工参考标签的样本验证,不能仅凭模型自报的置信度决定。
串联从视频读取到标签写回的流程
确定模型分工后,还需要串联数据准备、模型调用和结果处理:
读取视频 → 解码与抽帧 → 按任务分流 → 模型标注 → 校验与复核 → 写回
视频先从存储中读取,经过解码与抽帧形成输入,再按任务规则进入不同推理路径。输出需要检查字段格式、标签范围及业务约束,将待复核结果分流,并与视频、时间戳等来源信息关联写回,方便追踪和后续更新。
两条推理路径有不同的约束。自部署模型受 GPU 数量、显存和数据供给速度影响;GPT-6 Astra API 受请求配额、响应延迟和费用影响。团队需要分别配置提交节奏与资源预算,再协调结果汇总,使任务在预算和处理时限内完成。即使推理本身足够快,读取、解码或写回跟不上,整条流程的交付速度仍会受限。
用 Vane Data 高效执行多模态标注流水线
Vane Data 是面向 AI 工作负载的多模态数据处理与执行引擎,基于 DuckDB 分支扩展,提供 Python 和 SQL 接口,既可在本地运行,也可扩展到 Ray 集群。
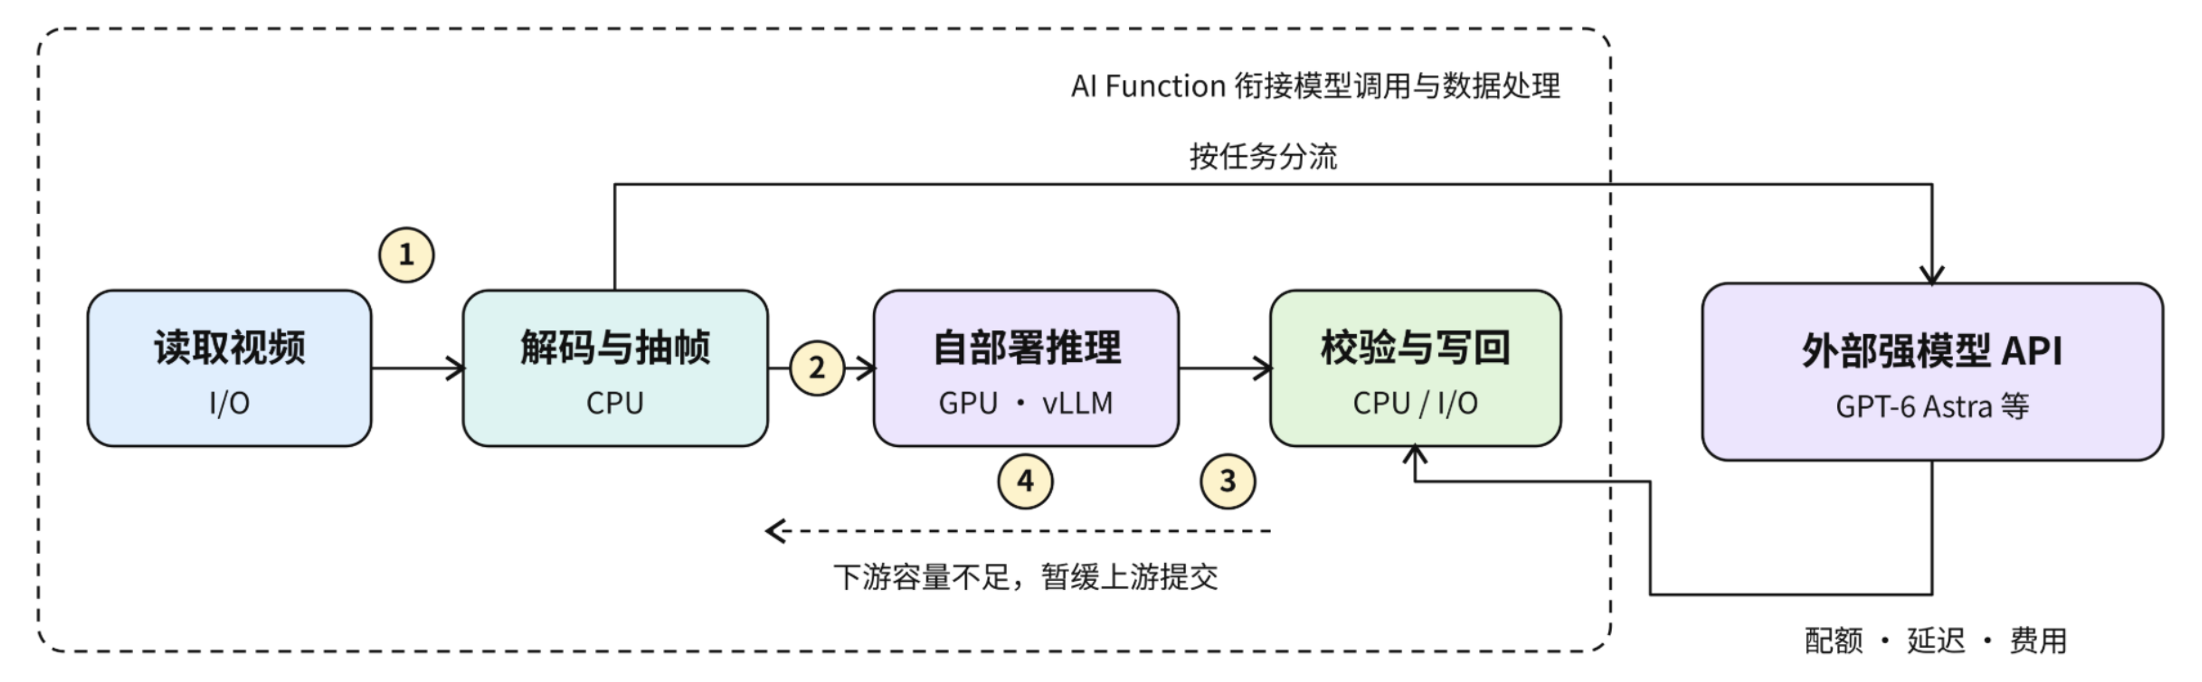
在这条体育视频标注流水线中,团队可以通过 AI Function 调用 GPT-6 Astra API,并将返回的标注结果交给后续步骤处理。常规任务的自部署批量推理也可以放在同一流水线中,由业务规则决定任务分流和结果校验方式。
减少等待、积压与重复计算
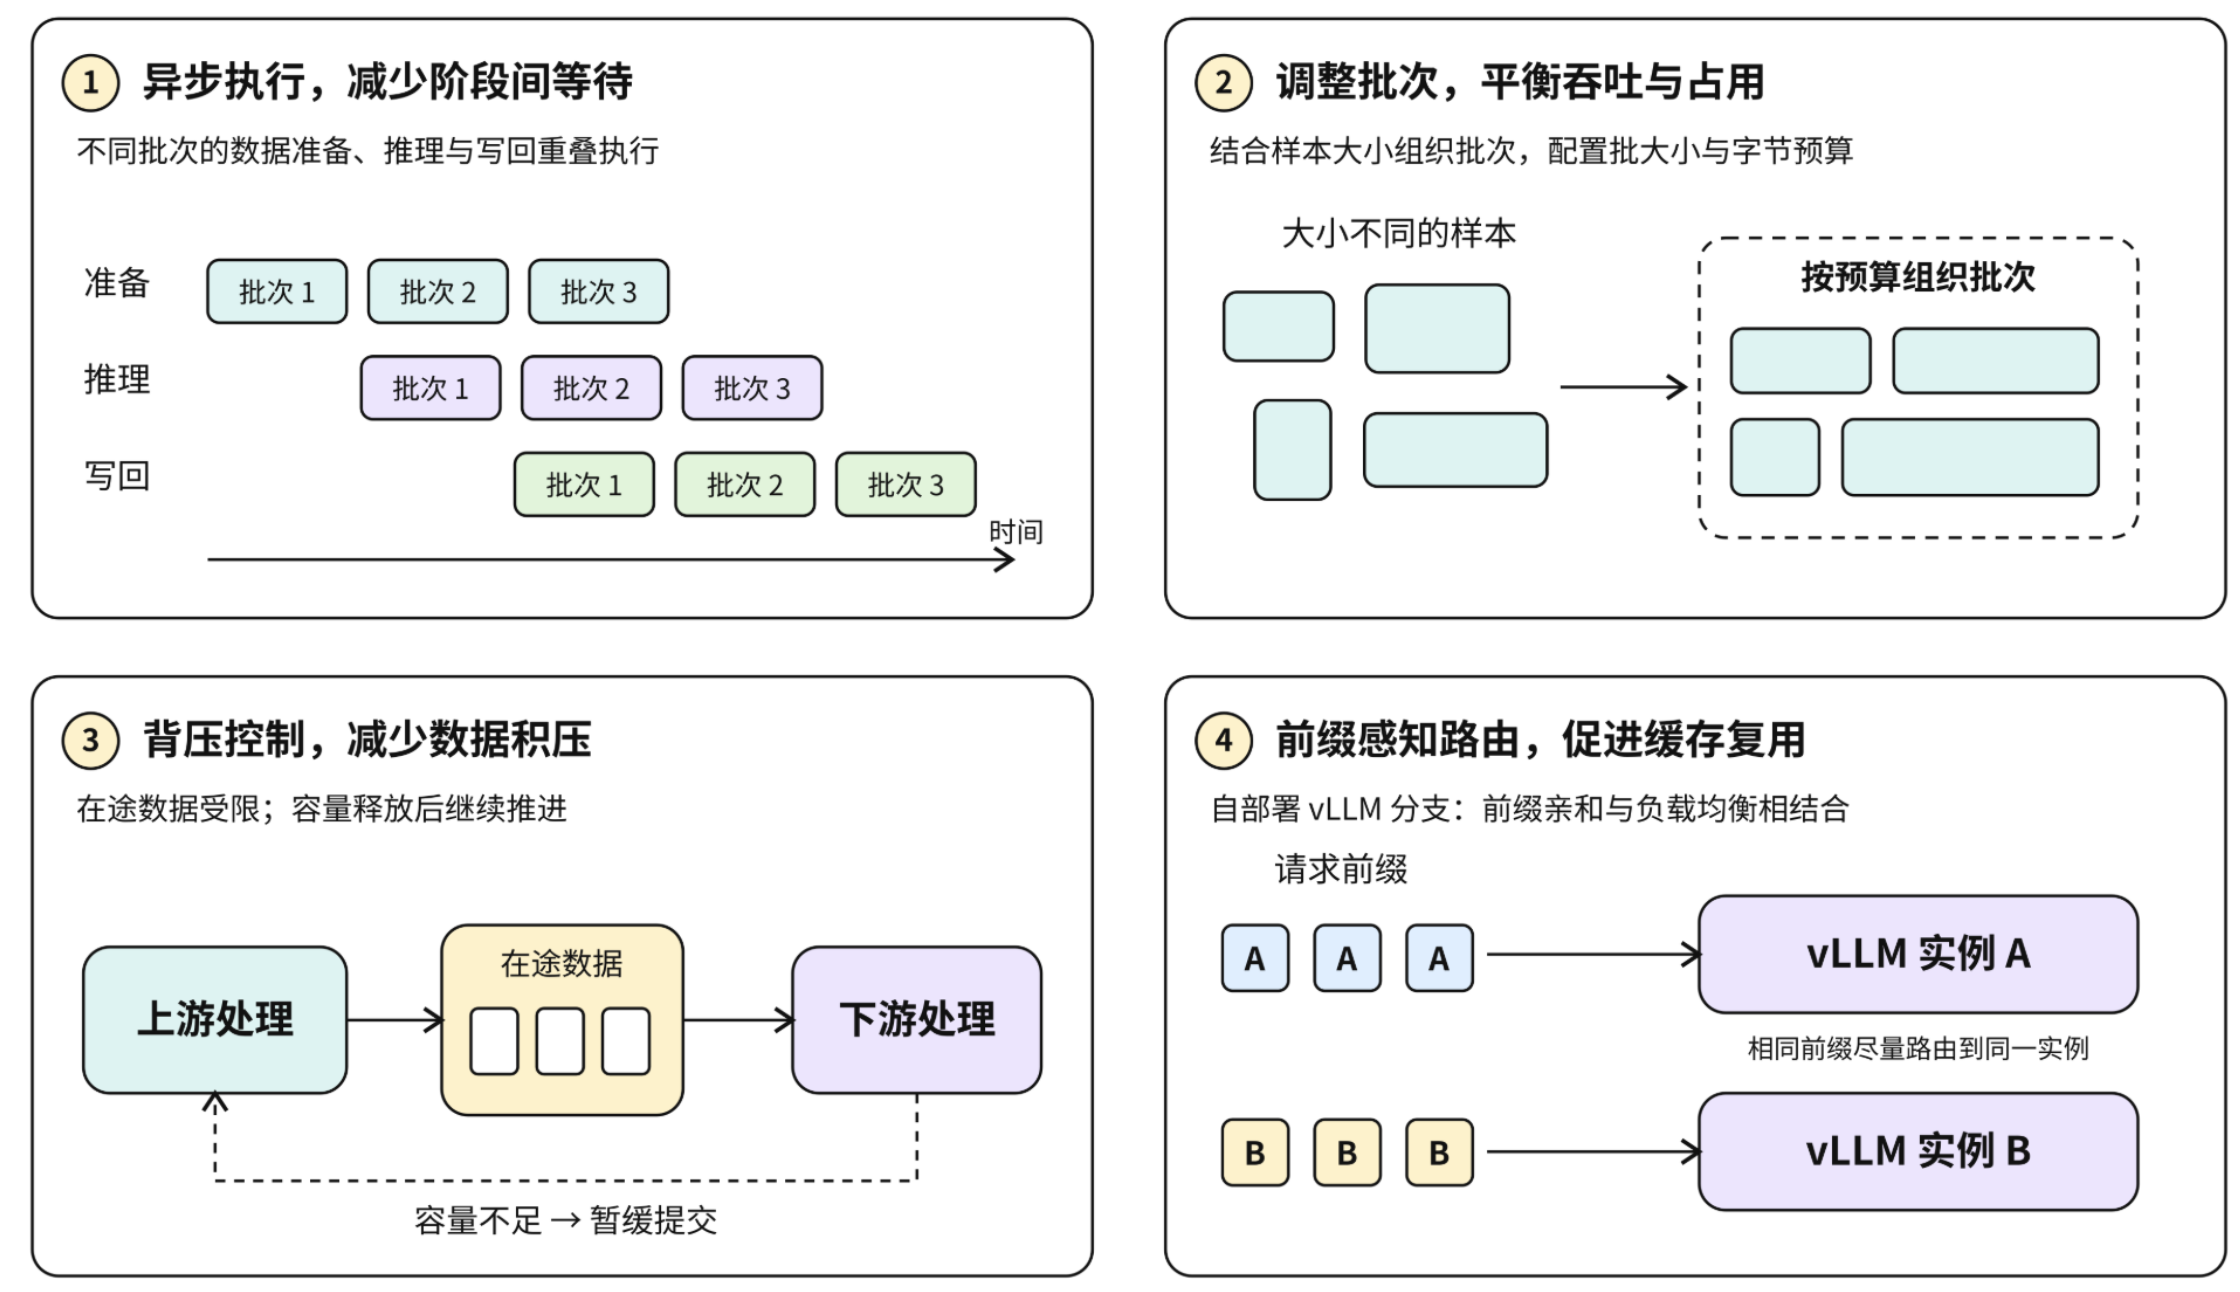
模型调用进入数据流后,执行效率取决于各阶段能否衔接顺畅。规模扩大后,输入供给不足、批次大小不当、中间数据积压和重复计算,都可能限制流水线的吞吐。
**异步执行,减少阶段间等待。**如果读取、解码和模型调用依次等待完成,各阶段之间就容易出现空闲。Vane Data 通过异步提交,在等待模型结果时推进其他就绪工作,让 CPU、GPU 和 I/O 工作有机会重叠执行,减少串行等待。
**调整批次,平衡吞吐与资源占用。**视频长度、图片尺寸和中间结果大小不同,相同记录数对应的内存与计算开销可能相差很大。批次过小难以摊薄开销,过大又会增加资源压力。Vane Data 通过批大小配置、数据切分与聚合组织各阶段的输入输出,并结合字节预算控制数据占用。
**背压控制,减少中间数据积压。**上游提交速度超过推理或写回速度,缓冲数据与在途请求就会持续增长。Vane Data 通过在途数据限制和背压约束上游提交,待容量释放后再推进,控制长时间运行中的中间数据积压。
**前缀感知路由,促进缓存复用。**大量样本使用相同的标注规范和示例,本地部署的推理模型存在公共前缀复用的机会。Vane Data 对公共前缀进行分桶,并以兼顾负载的亲和路由组织请求,为 vLLM 复用前缀缓存创造条件,减少重复的预填充计算。
在有限资源下,产出更多合格标签
更强的模型让更多标注任务变得可行,而标注流水线的执行效率影响这些任务能以怎样的成本和速度完成。Vane Data 将数据处理、模型调用和结果写回组织在一起,帮助团队在既定资源下产出更多合格标签。
想了解具体用法,可以阅读从文件到可查询数据的示例文章;性能测试结果与配置见 Vane Data Benchmark 页面。