用 Vane Data + Lance 做商品类目辅助审核
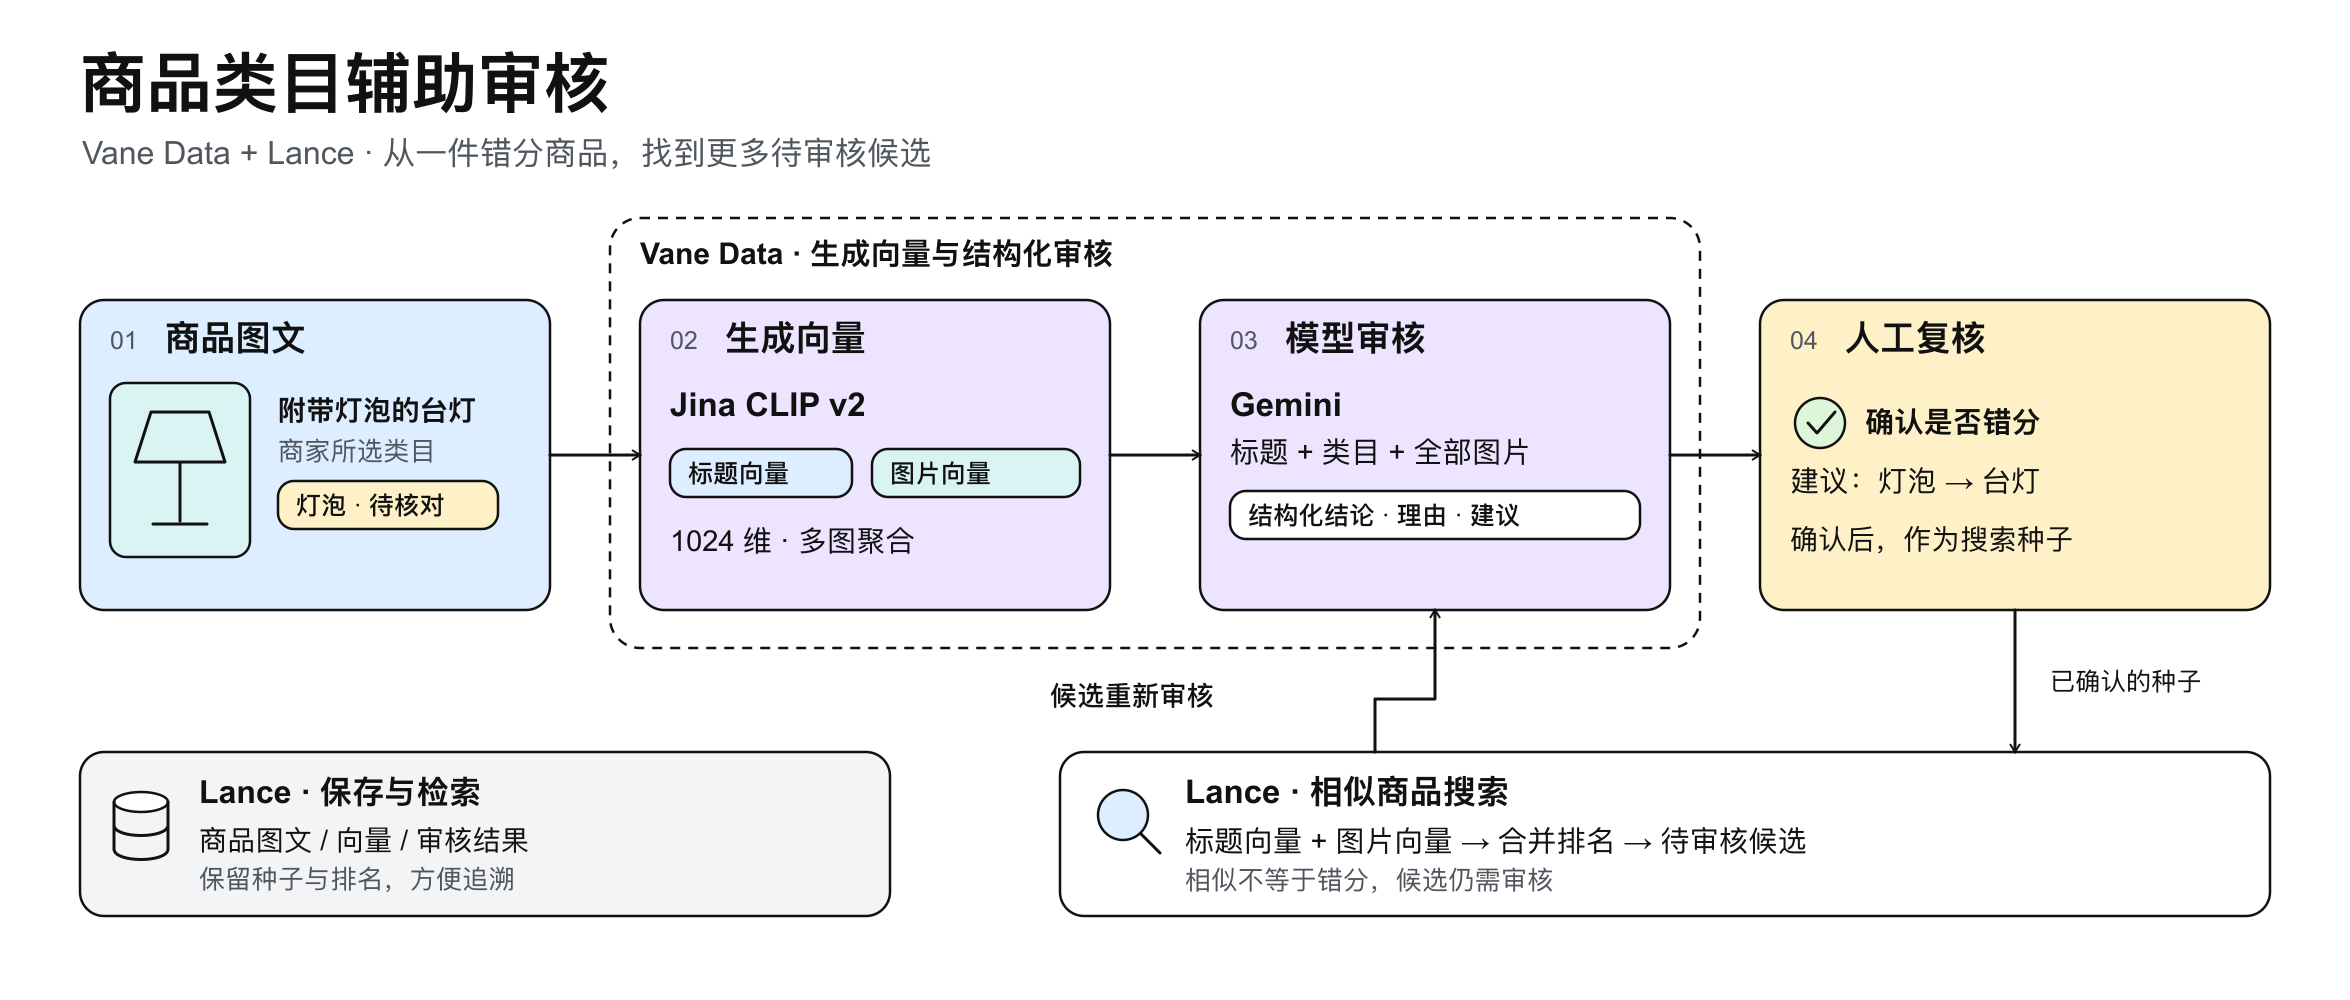
商家上传商品时可能选错类目,人工逐条核对图文很费时。本文用一小批商品演示如何辅助审核:先让模型检查标题、图片和类目是否一致,标出可疑记录供人工复核;确认一件商品错分后,再用相似搜索找出同批值得检查的其他商品。
这套方案中,各部分的分工是:
- Lance:保存商品图文、向量和审核结果,检索相似商品。
- Vane Data:整理图文、生成向量、调用模型,把模型回答转成结构化数据。
- 人工:复核可疑记录,确认是否需要纠正类目。
模型和相似搜索用于筛选待检查的商品,最终判断由人工完成。
代码按 Lance Extension for Vane 的约定实现:vane.connect() 默认走 Ray,所以整条流水线不设置 VANE_RUNNER,也不调用 runner 选择接口。商品与审核结果通过 ATTACH ... (TYPE LANCE) 加 relation.create() / relation.insert_into() 写入 Lance,看结果用 .show(),Python 需要行数据时用 .fetchall(),向量搜索用 lance_vector_search。模型和相似搜索只回答“哪些记录值得检查”,不负责判定类目对错。
从一件已确认的错分商品开始
案例中的商品 B073P3NK7T 标题是 “Table Desk Lamp With Bulb”,意思是“附带灯泡的台灯”。按案例设定,这是一盏完整台灯,应归到 Table Lamp(台灯),商家却把它放进了 Light Bulb(灯泡)。示例代码默认生成占位图;要检查真实图文是否一致,需要换成实际商品图片。
审核人员先确认这一件确实错分。这个确认就是后续流程的种子:在同批商品中分别用标题向量和图片向量搜索靠近它的商品,对候选再走一轮审核,最终仍然由人工判断。
下面这一批有 8 件商品,其中 B011AA1004 既缺图片也缺类目。它会保留在源表里,但不会进入向量和审核环节。
准备运行环境
向量和视觉审核需要两个免费 key:Jina 用于 jina-clip-v2,Google AI Studio 用于审核模型。8 件商品的用量远低于两个免费档的额度。
使用下面的命令安装 Vane Data 和 Lance 扩展:
export JINA_API_KEY="..."
export GOOGLE_API_KEY="..."


python -m pip install vane-ai vane-extension-lance "grpcio>=1.42.0"
然后建立连接、加载 Lance 扩展,并挂上用于写入的命名空间:
import vane


connection = vane.connect()
vane.load_installed_extension("lance", connection=connection)


# 写 Lance 的目标命名空间(目录不存在会自动创建):
connection.execute("ATTACH 'lance_store' AS lance_ns (TYPE LANCE, READ_ONLY false)")
1. 准备商品图文
流水线读三张源表:products 存商品 ID、标题和类目 ID;product_images 存图片字节、来源和主图标记;categories 存类目名称。
元数据连接不做聚合,缺图片或缺类目的商品因此不会在连接时被丢掉。图片在 Python 侧按商品组装,主图排在前面:这批数据很小,用 Python 排序保证结果确定,不依赖分布式执行是否保序。组装好的行再变成随 plan 走的常量 relation,这与官方 querying_images.py 示例采用同一种模式。
最后检查资料是否完整:有标题、有类目、至少有一张图的记录继续往下走。不完整的记录保留在源表里,只是不生成向量,也不进入审核。
# 种子数据:8 件商品,含 B073P3NK7T;其中 B011AA1004 既缺图又缺类目,
# 用于演示下面的 is_complete 检查。真实接入 ABO 时,
# 把下面的 VALUES 换成 ABO 的 listings 数据(CC BY 4.0,见文末说明),
# 把 abo_images/ 换成 ABO 图片目录即可,SQL 不用改。
connection.sql("""
    SELECT * FROM (VALUES
      ('B073P3NK7T', 'Table Desk Lamp With Bulb',      'cat_bulb'),
      ('B073Q8LM2A', 'Modern Fabric Table Lamp Shade', 'cat_lamp'),
      ('B073R1N9QW', 'Vintage Brass Desk Lamp',        'cat_lamp'),
      ('B011AA1001', 'LED Light Bulb 60W Equivalent',  'cat_bulb'),
      ('B011AA1002', 'Edison Vintage Bulb 4-Pack',     'cat_bulb'),
      ('B011AA1003', 'Table Lamp With USB Port',       'cat_bulb'),
      ('B011AA1004', 'Ceramic Table Lamp Base',        NULL),
      ('B011AA1005', 'Glass Pendant Light Shade',      'cat_lamp')
    ) AS t(item_id, title, merchant_category_id)
""").create("lance_ns.main.products")


connection.sql("""
    SELECT * FROM (VALUES
      ('cat_lamp', 'Table Lamp'),
      ('cat_bulb', 'Light Bulb')
    ) AS t(category_id, category_name)
""").create("lance_ns.main.categories")
# 每件商品 1~2 张图,文件名形如 <item_id>_0.jpg,
# 主图序号为 0。只为缺失的文件生成占位图,
# 有真实 ABO 图(CC BY 4.0)时可用同名文件覆盖。
from pathlib import Path
from PIL import Image


Path("abo_images").mkdir(exist_ok=True)
for item in ["B073P3NK7T", "B073Q8LM2A", "B073R1N9QW", "B011AA1001",
             "B011AA1002", "B011AA1003", "B011AA1005"]:
    for k in range(2 if item in ("B073P3NK7T", "B011AA1003") else 1):
        p = Path(f"abo_images/{item}_{k}.jpg")
        if not p.exists():
            Image.new("RGB", (64, 64), (200 - k * 40, 180, 160)).save(p, format="JPEG")


# B011AA1004 故意不放图:演示商品保留在源表里,
# 但不会进入审核。
connection.sql("""
    SELECT 'B073P3NK7T' AS item_id, content AS image_bytes, 'abo' AS source, TRUE  AS is_main, 0 AS position FROM read_blob('abo_images/B073P3NK7T_0.jpg')
    UNION ALL SELECT 'B073P3NK7T', content, 'abo', FALSE, 1 FROM read_blob('abo_images/B073P3NK7T_1.jpg')
    UNION ALL SELECT 'B073Q8LM2A', content, 'abo', TRUE,  0 FROM read_blob('abo_images/B073Q8LM2A_0.jpg')
    UNION ALL SELECT 'B073R1N9QW', content, 'abo', TRUE,  0 FROM read_blob('abo_images/B073R1N9QW_0.jpg')
    UNION ALL SELECT 'B011AA1001', content, 'abo', TRUE,  0 FROM read_blob('abo_images/B011AA1001_0.jpg')
    UNION ALL SELECT 'B011AA1002', content, 'abo', TRUE,  0 FROM read_blob('abo_images/B011AA1002_0.jpg')
    UNION ALL SELECT 'B011AA1003', content, 'abo', TRUE,  0 FROM read_blob('abo_images/B011AA1003_0.jpg')
    UNION ALL SELECT 'B011AA1003', content, 'abo', FALSE, 1 FROM read_blob('abo_images/B011AA1003_1.jpg')
    UNION ALL SELECT 'B011AA1005', content, 'abo', TRUE,  0 FROM read_blob('abo_images/B011AA1005_0.jpg')
""").create("lance_ns.main.product_images")
# 元数据左连接(无聚合),保留缺图片、缺类目的商品;
# 再把这批数据取到 Python,按商品组装图片并让主图排在前面,
# 然后把组装好的行变回常量 relation。
# 源表不动:不完整的记录被保留,
# 而不是被悄悄丢掉。
from collections import defaultdict


meta_rows = connection.sql("""
    SELECT p.item_id, p.title, p.merchant_category_id,
           c.category_name AS merchant_category
    FROM lance_ns.main.products p
    LEFT JOIN lance_ns.main.categories c
      ON c.category_id = p.merchant_category_id
    ORDER BY p.item_id
""").fetchall()


img_rows = connection.sql("""
    SELECT item_id, image_bytes, source, is_main, position
    FROM lance_ns.main.product_images
    ORDER BY item_id, position
""").fetchall()


imgs = defaultdict(list)
for item_id, blob, source, is_main, pos in img_rows:
    imgs[item_id].append((bool(is_main), int(pos), bytes(blob)))
for parts in imgs.values():
    parts.sort(key=lambda t: (not t[0], t[1]))  # 主图优先,同组按 position


def quote_ident(v):
    return '"' + v.replace('"', '""') + '"'


assembled = []
for item_id, title, cat_id, cat_name in meta_rows:
    images = [b for _, _, b in imgs.get(item_id, [])]
    is_complete = (title is not None
                   and cat_id is not None
                   and len(images) > 0)
    assembled.append({"item_id": item_id, "title": title,
                      "merchant_category_id": cat_id,
                      "merchant_category": cat_name,
                      "images": images, "is_complete": is_complete})


cols = ["item_id", "title", "merchant_category_id",
        "merchant_category", "images", "is_complete"]
raw = connection.values(
    *(tuple(vane.ConstantExpression(r[c]) for c in cols) for r in assembled))
proj = ", ".join(f"{quote_ident(s)} AS {quote_ident(c)}"
                 for s, c in zip(raw.columns, cols, strict=True))
complete = raw.query(
    "input_rows", f"select {proj} from input_rows").filter(
        vane.col("is_complete"))
complete.select("item_id").show()
# 8 件里 B011AA1004(缺图、缺类目)is_complete = false,被过滤,不再往下走。
2. 生成向量
标题向量和图片向量都来自 Jina 的 jina-clip-v2,输出 1024 维。标题走文本输入,图片走图像输入;同一个模型让两者落在同一个向量空间,以后想做图文互搜也方便。
Vane 的 vane.ai.embed 支持 OpenAI、Google、Transformers,不含 Jina,所以两路向量都走 map_batches 调 Jina 的 /v1/embeddings 接口。JINA_API_KEY 只从环境变量读。
同一件商品有多张图时,按三步处理:
- 每张图分别生成向量并归一化;
- 对多张图的向量逐维取平均;
- 再归一化一次。
这样主图和场景图会合成每件商品的一个图片向量。
import base64, io, os
import numpy as np
import pyarrow as pa
import requests
from PIL import Image


JINA_URL = "https://api.jina.ai/v1/embeddings"


# 标题向量:每批标题一次请求,返回的向量已经归一化。
def embed_titles_jina(batch: pa.Table) -> pa.Table:
    titles = batch.column("title").to_pylist()
    api_key = os.environ["JINA_API_KEY"]  # 只从环境变量读
    resp = requests.post(
        JINA_URL,
        headers={"Content-Type": "application/json",
                 "Authorization": f"Bearer {api_key}"},
        json={"model": "jina-clip-v2",
              "dimensions": 1024,
              "normalized": True,
              "embedding_type": "float",
              "input": [{"text": t} for t in titles]},
        timeout=120,
    )
    resp.raise_for_status()
    vecs = [d["embedding"] for d in resp.json()["data"]]
    return pa.table({
        "item_id": batch.column("item_id"),
        "title": batch.column("title"),
        "merchant_category_id": batch.column("merchant_category_id"),
        "merchant_category": batch.column("merchant_category"),
        "images": batch.column("images"),
        "title_vec": pa.array(vecs, type=pa.list_(pa.float32(), 1024)),
    })


with_title_vec = complete.map_batches(
    embed_titles_jina,
    schema={"item_id": "VARCHAR",
            "title": "VARCHAR",
            "merchant_category_id": "VARCHAR",
            "merchant_category": "VARCHAR",
            "images": "BLOB[]",
            "title_vec": "FLOAT[1024]"},
    batch_size=16,  # 标题是短文本,batch 可以大一些
)
with_title_vec.show()
# 图片向量走同一个 Jina 接口的图片输入。每张图单独请求、
# 逐个归一化,再按商品平均后二次归一化——
# 正好对应上面的三步。
# UDF 把整行透传并附上 image_vec,下游不需要再做表连接,
# 一步写入 Lance。
def _to_data_url(raw: bytes) -> str:
    img = Image.open(io.BytesIO(bytes(raw))).convert("RGB")
    img.thumbnail((512, 512))  # jina-clip-v2 按 512 切片,先缩到 512 省 token
    buf = io.BytesIO()
    img.save(buf, format="PNG")
    return "data:image/png;base64," + base64.b64encode(buf.getvalue()).decode()


def _l2(a: np.ndarray) -> np.ndarray:
    n = float(np.linalg.norm(a))
    return a / n if n > 0 else a


def embed_images_passthrough(batch: pa.Table) -> pa.Table:
    all_images = batch.column("images").to_pylist()  # BLOB[]
    api_key = os.environ["JINA_API_KEY"]  # 只从环境变量读
    out = []
    for images in all_images:
        raws = [bytes(b) for b in (images or []) if b]
        if not raws:
            out.append(None)
            continue
        resp = requests.post(
            JINA_URL,
            headers={"Content-Type": "application/json",
                     "Authorization": f"Bearer {api_key}"},
            json={"model": "jina-clip-v2",
                  "dimensions": 1024,
                  "normalized": False,  # 手动做归一化→平均→再归一化
                  "embedding_type": "float",
                  "input": [{"image": _to_data_url(r)} for r in raws]},
            timeout=120,
        )
        resp.raise_for_status()
        vecs = [_l2(np.array(d["embedding"], dtype=np.float64))
                for d in resp.json()["data"]]
        out.append(_l2(np.mean(vecs, axis=0)).astype(np.float32).tolist())
    return pa.table({
        "item_id": batch.column("item_id"),
        "title": batch.column("title"),
        "merchant_category_id": batch.column("merchant_category_id"),
        "merchant_category": batch.column("merchant_category"),
        "images": batch.column("images"),
        "title_vec": batch.column("title_vec"),
        "image_vec": pa.array(out, type=pa.list_(pa.float32(), 1024)),
    })


with_both_vecs = with_title_vec.map_batches(
    embed_images_passthrough,
    schema={"item_id": "VARCHAR",
            "title": "VARCHAR",
            "merchant_category_id": "VARCHAR",
            "merchant_category": "VARCHAR",
            "images": "BLOB[]",
            "title_vec": "FLOAT[1024]",
            "image_vec": "FLOAT[1024]"},
    batch_size=4,  # 图片请求重,batch 调小
)
with_both_vecs.show()
# 存进 Lance。小批量用精确搜索,不建向量索引;
# 数据量大时再用 pylance SDK 建 IVF_PQ 索引
# (索引管理 SQL 不在 Ray 的约定内)。
with_both_vecs.create("lance_ns.main.products_search")


connection.sql("SELECT count(*) AS rows FROM lance_ns.main.products_search").show()
# rows = 7:8 件里有 1 件资料不完整,没有进入这张表
3. 用模型审核这批商品
将每件商品的标题、类目名称和全部图片一起交给模型,要求它返回以下字段:
- recognized_product:识别出的商品;
- verdict:类目是否匹配;
- suggested_category:建议类目,可以为空;
- confidence:模型自报的置信度;
- reason:判断理由。
verdict 有三种值:
- match:标题和图片支持当前类目;
- mismatch:图文表明应属于其他类目;
- uncertain:信息不足或相互矛盾,无法确定。
模型只做辅助判断。confidence 是模型自报的置信度,不是测得的概率。最终仍然由人工确认。
# 提示词列:标题和商家类目拼成一段文字;图片列直接传 BLOB[],
# 模型能同时看到全部图片。
to_audit = connection.sql("""
    SELECT item_id, title, merchant_category_id, merchant_category,
           images, title_vec, image_vec,
           ('Product title: ' || title
            || '. Merchant category: ' || coalesce(merchant_category, 'unknown')
            || '. Decide whether the title and ALL images support this category.'
           ) AS audit_prompt
    FROM lance_ns.main.products_search
""")


# 结构化输出:对象封闭、属性全 required 的可移植 JSON Schema 子集,
# 可空的建议类目用 ["string", "null"] 表示。
audit_schema = {
    "type": "object",
    "properties": {
        "recognized_product": {"type": "string"},
        "verdict": {"type": "string",
                    "enum": ["match", "mismatch", "uncertain"]},
        "suggested_category": {"type": ["string", "null"]},
        "confidence": {"type": "number"},
        "reason": {"type": "string"},
    },
    "required": ["recognized_product", "verdict", "suggested_category",
                 "confidence", "reason"],
    "additionalProperties": False,
}
import vane.ai


# 审核模型用 Gemini(Vane 内置 google provider,
# GOOGLE_API_KEY 从环境变量读)。几点实践经验:
# 模型名以 key 能列出的为准(本次运行以 gemini-3.5-flash-lite 通过);
# 3.x 模型不支持 temperature 等经典采样参数,别传;
# max_output_tokens 给足(2048),3.x 的思考过程也占输出额度;
# 免费档 RPM 低,串行发送。
audited = vane.ai.prompt(
    to_audit,
    [vane.col("audit_prompt"), vane.col("images")],  # 文字 + 全部图片
    provider="google",
    model="gemini-3.5-flash-lite",
    system_message=("You are a product-category audit assistant. "
                    "Judge only from the given title and images; "
                    "never invent unseen details."),
    return_format=audit_schema,  # 返回原生 STRUCT 列 audit
    output_column="audit",
    max_output_tokens=2048,
    batch_size=1,
    actor_number=1,
    max_concurrency_per_actor=1,
)


audited.select(vane.col("item_id"), vane.col("title"),
               vane.col("merchant_category"), vane.col("audit")).show()
4. 保存结果,只看可疑记录
审核结果存进新表 products_category_audit,搜索表和候选表都不修改。审核表保留商品的图文、向量和检索溯源,同时增加模型判断、建议类目、理由和审核状态。
# 拆 STRUCT 为平铺列,加上审核状态;检索溯源字段(种子、排名)
# 先置 NULL,扩线时填充。
audited.select(
    vane.col("item_id"), vane.col("title"),
    vane.col("merchant_category_id"), vane.col("merchant_category"),
    vane.col("images"), vane.col("title_vec"), vane.col("image_vec"),
    vane.sql_expr("CAST(NULL AS VARCHAR)").alias("seed_item_id"),
    vane.sql_expr("CAST(NULL AS BIGINT)").alias("retrieval_rank"),
    vane.sql_expr("audit.recognized_product").alias("recognized_product"),
    vane.sql_expr("audit.verdict").alias("verdict"),
    vane.sql_expr("audit.suggested_category").alias("suggested_category"),
    vane.sql_expr("audit.confidence").alias("confidence"),
    vane.sql_expr("audit.reason").alias("reason"),
    vane.lit("completed").alias("audit_status"),
).create("lance_ns.main.products_category_audit")
人工先查模型认为类目不符的记录:
SELECT item_id, merchant_category, recognized_product,
       verdict, suggested_category, reason, images
FROM products_category_audit
WHERE audit_status = 'completed'
  AND verdict = 'mismatch'
ORDER BY retrieval_rank;
connection.sql("""
    SELECT item_id, merchant_category, recognized_product,
           verdict, suggested_category, reason, images
    FROM lance_ns.main.products_category_audit
    WHERE audit_status = 'completed'
      AND verdict = 'mismatch'
    ORDER BY retrieval_rank
""").show()
审核人员可以在同一条记录中查看:
- 商家原来选的类目
- 模型识别出的商品
- 模型建议的类目
- 模型给出的理由
- 原始图片
人工确认后,再把需要纠正的商品交给上架系统处理。对于模型返回 uncertain 的记录,也需要另行复核,不能视为审核通过。
5. 用相似搜索扩线
如果人工确认某件商品确实错分,可以用它作为种子,搜索同批相似商品。
分别用种子的标题向量和图片向量搜索,得到两份排名,再按商品 ID 合并。两路排名都靠前的商品,综合排名更高;只命中一路的商品,也可能进入最终候选。
对这些候选,可以再做一轮模型审核,也可以直接交给人工复核。搜索结果只表示商品相似,是否存在同样的类目错误,还需要逐件确认。
这样就能从一件已确认的错分商品出发,找到同批可能同样错分的其他商品,作为下一轮检查的重点。下面的代码演示如何搜索、合并排名,并将候选写入审核表。
# 取出已确认错分的种子向量(Python 需要行数据 → 用 fetchall):
seed_rows = connection.sql("""
    SELECT title_vec, image_vec
    FROM lance_ns.main.products_search
    WHERE item_id = 'B073P3NK7T'
""").fetchall()
seed_title_vec, seed_image_vec = seed_rows[0]


def vec_literal(vec, dim):
    return "[" + ",".join(repr(float(x)) for x in vec) + f"]::FLOAT[{dim}]"


# 两路精确搜索(use_index = false,小批量不需要向量索引)。
# 命中先落盘成 Lance 表,后续合并才能在 Ray 上读到
# (单条 SQL 里的中间 relation 跨语句不可见)。
connection.sql(f"""
    SELECT item_id, _distance AS title_distance
    FROM lance_vector_search(
        'lance_store/products_search.lance', 'title_vec',
        {vec_literal(seed_title_vec, 1024)},
        k = 5, use_index = false, prefilter = true
    )
""").create("lance_ns.main.title_hits")


connection.sql(f"""
    SELECT item_id, _distance AS image_distance
    FROM lance_vector_search(
        'lance_store/products_search.lance', 'image_vec',
        {vec_literal(seed_image_vec, 1024)},
        k = 5, use_index = false, prefilter = true
    )
""").create("lance_ns.main.image_hits")
# 按商品 ID 合并排名:两路都靠前则综合排名更高,
# 只命中一路也保留。融合分 = 两路排名之和
# (缺席按 k+1 计),越小越靠前。
connection.sql("""
    WITH t AS (
        SELECT item_id, title_distance,
               row_number() OVER (ORDER BY title_distance ASC, item_id ASC) AS title_rank
        FROM lance_ns.main.title_hits
    ),
    m AS (
        SELECT item_id, image_distance,
               row_number() OVER (ORDER BY image_distance ASC, item_id ASC) AS image_rank
        FROM lance_ns.main.image_hits
    )
    SELECT coalesce(t.item_id, m.item_id) AS item_id,
           t.title_rank, m.image_rank,
           coalesce(t.title_rank, 6) + coalesce(m.image_rank, 6) AS fused_score,
           row_number() OVER (
               ORDER BY coalesce(t.title_rank, 6) + coalesce(m.image_rank, 6) ASC,
                        coalesce(t.title_rank, 6) ASC,
                        coalesce(m.image_rank, 6) ASC
           ) AS retrieval_rank
    FROM t FULL OUTER JOIN m USING (item_id)
    WHERE coalesce(t.item_id, m.item_id) <> 'B073P3NK7T'  -- 去掉种子自身
    ORDER BY retrieval_rank
    LIMIT 10
""").create("lance_ns.main.candidates")


connection.sql("SELECT * FROM lance_ns.main.candidates ORDER BY retrieval_rank").show()
# 候选写回审核表(保留检索溯源),
# 再走第 3 步的模型审核或直接人工看:
connection.sql("""
    SELECT s.item_id, s.title, s.merchant_category_id, s.merchant_category,
           s.images, s.title_vec, s.image_vec,
           'B073P3NK7T' AS seed_item_id,
           c.retrieval_rank,
           CAST(NULL AS VARCHAR) AS recognized_product,
           CAST(NULL AS VARCHAR) AS verdict,
           CAST(NULL AS VARCHAR) AS suggested_category,
           CAST(NULL AS DOUBLE) AS confidence,
           CAST(NULL AS VARCHAR) AS reason,
           'pending' AS audit_status
    FROM lance_ns.main.products_search s
    JOIN lance_ns.main.candidates c USING (item_id)
""").insert_into("lance_ns.main.products_category_audit")
代码执行到这里,候选已作为 pending 记录追加到审核表,并保留种子商品 ID 和检索排名,方便追溯来源。第二轮模型审核或人工复核需要后续执行;如果选择模型审核,可以参考第 3 步,对这批候选调用模型。
运行结果
原始演示记录了 7 件完整商品的处理结果,使用 Jina 生成向量、Gemini 审核,运行在默认 Ray runner 上。以下保留原稿中的模型输出;其中 B011AA1005 的商家类目已按种子数据统一为 Table Lamp,该条模型输出尚未按此输入重新验证。
| 商品 | 商家类目 | 识别商品 | 结论 | 建议类目 | 置信度 |
|---|---|---|---|---|---|
| B073P3NK7T | Light Bulb | Table Desk Lamp | mismatch | Table Lamps | 0.95 |
| B011AA1003 | Light Bulb | Table Lamp With USB Port | mismatch | Table Lamps | 0.95 |
| B011AA1005 | Table Lamp | Glass Pendant Light Shade | mismatch | Pendant Light Shade | 0.95 |
| B073Q8LM2A | Table Lamp | Modern Fabric Table Lamp Shade | mismatch | Lamp Shades | 0.95 |
| B011AA1001 | Light Bulb | LED Light Bulb | match | — | 0.5 |
| B011AA1002 | Light Bulb | Edison Vintage Bulb | match | — | 1.0 |
| B073R1N9QW | Table Lamp | Vintage Brass Desk Lamp | match | — | 1.0 |
以 B073P3NK7T 为种子扩线,综合排名第 1 的正是另一件错放的 B011AA1003:
| 排名 | 商品 | 标题排名 | 图片排名 |
|---|---|---|---|
| 1 | B011AA1003 | 2 | 2 |
| 2 | B011AA1001 | 5 | 3 |
| 3 | B073R1N9QW | 3 | — |
这次演示使用占位图,模型判断主要依据标题。结果展示了向量入库、结构化审核和两路搜索合并的处理过程,不能用于评估真实商品图片的审核效果或检索质量。评估这两项能力,需要换上真实图片并重新运行。
小结
这套流程将商品图文、模型判断和检索来源保存在 Lance 中,审核人员可以查询可疑记录并核对依据。确认一件商品错分后,还能通过标题和图片搜索扩大检查范围。示例到生成待审核候选为止,最终类目修改仍由人工确认后交给上架系统处理。
数据说明:商品数据来源为 Amazon Berkeley Objects(ABO),许可证为 CC BY 4.0。代码使用手工列出的示例记录,缺图时生成占位图;商家错分类目和批量审核的情节均为演示设定,不代表 ABO 中的真实事件。