Apache Doris + Vane:让多模态文件进入 AI 检索与分析
订单、工单和生产批次已经进入数据库,但客户对产品的很多具体反馈,仍然存在客服录音、文字记录和附件中。
当团队想知道“还有哪些客户遇到了类似问题?这些反馈分别对应哪些生产批次?”时,通常需要先听录音、整理问题描述,再回到业务系统逐一核对。不同类型的数据虽然都已经存在,但还很难直接放在一起查询和分析。
Apache Doris 与 Vane 将这两类数据连接起来:Vane 将录音、图片、视频等多模态内容加工为文本、候选分类和向量;Doris 则将这些加工结果纳入已有业务数据体系,与订单、工单、生产批次等数据关联,让同一批内容既能用于相似案例检索,也能继续参与业务分析,并保留回到原始材料核查的线索。
Apache Doris:让多模态数据进入企业数据体系
企业里的 AI 检索,通常不只是“找到意思相近的内容”。真实的业务查询往往还带着明确的条件,例如产品型号、时间范围、设备类型,以及需要进一步核查的订单、工单和生产批次。
使用 Doris 承载业务数据,并在 Doris 中完成文本和向量检索,可以让这些业务条件与 AI 检索在同一套 SQL 查询中完成。
- **先用业务条件缩小范围,再查找相似内容。**例如,要查找“X1 型号最近一个月无法启动的反馈”,可以先限定产品型号和时间范围,再通过向量检索找到“按开关没反应”“通电后没有动静”等不同表述;如果还需要排查某个故障码,也可以同时加入文本匹配条件。业务条件负责确定查询范围,文本和向量检索则帮助找到相关内容。
- **找到反馈后,还可以继续关联和分析。**检索结果可以继续通过工单关联订单和生产批次,回答“这些相似反馈来自哪些客户、对应哪些批次”。在明确复核状态、统计范围和去重口径后,还可以进一步分析不同生产批次的问题工单分布及其随时间的变化,为质量排查提供依据。
- **已有的业务数据和 SQL 工作方式可以继续复用。**检索、关联和分析都可以在同一套数据体系中完成,减少向另一套检索系统复制业务字段、同步数据,以及在应用代码中拼接查询结果的工作。数据团队也可以继续使用熟悉的 SQL 完成过滤、关联和聚合,让新增的多模态数据接入已有的分析流程。
Apache Doris 将 AI 检索与业务数据分析放在同一套数据体系中,让“找到相关内容”之后,还能继续完成业务追溯和分析。
Doris + Vane:企业数据进入 AI 的完整链路
一份文件成为 AI 资产,需要经过从原始内容到可用数据的加工:文档解析与切分、录音转写、视频抽帧,再提取业务信息、生成向量。例如,售后录音经过处理,可以形成带有工单号、反馈片段、候选故障类别和向量的数据记录,并保留原始录音地址与时间位置,支持后续检索、关联分析和回溯核验。
这条链路需要组织多步计算。文件大小和处理成本各不相同,一个输入可能展开为大量片段;读取、解析与模型推理的速度也不一致。用 Python 脚本跑通之后,团队还需持续维护批次、并发、模型复用和失败处理。
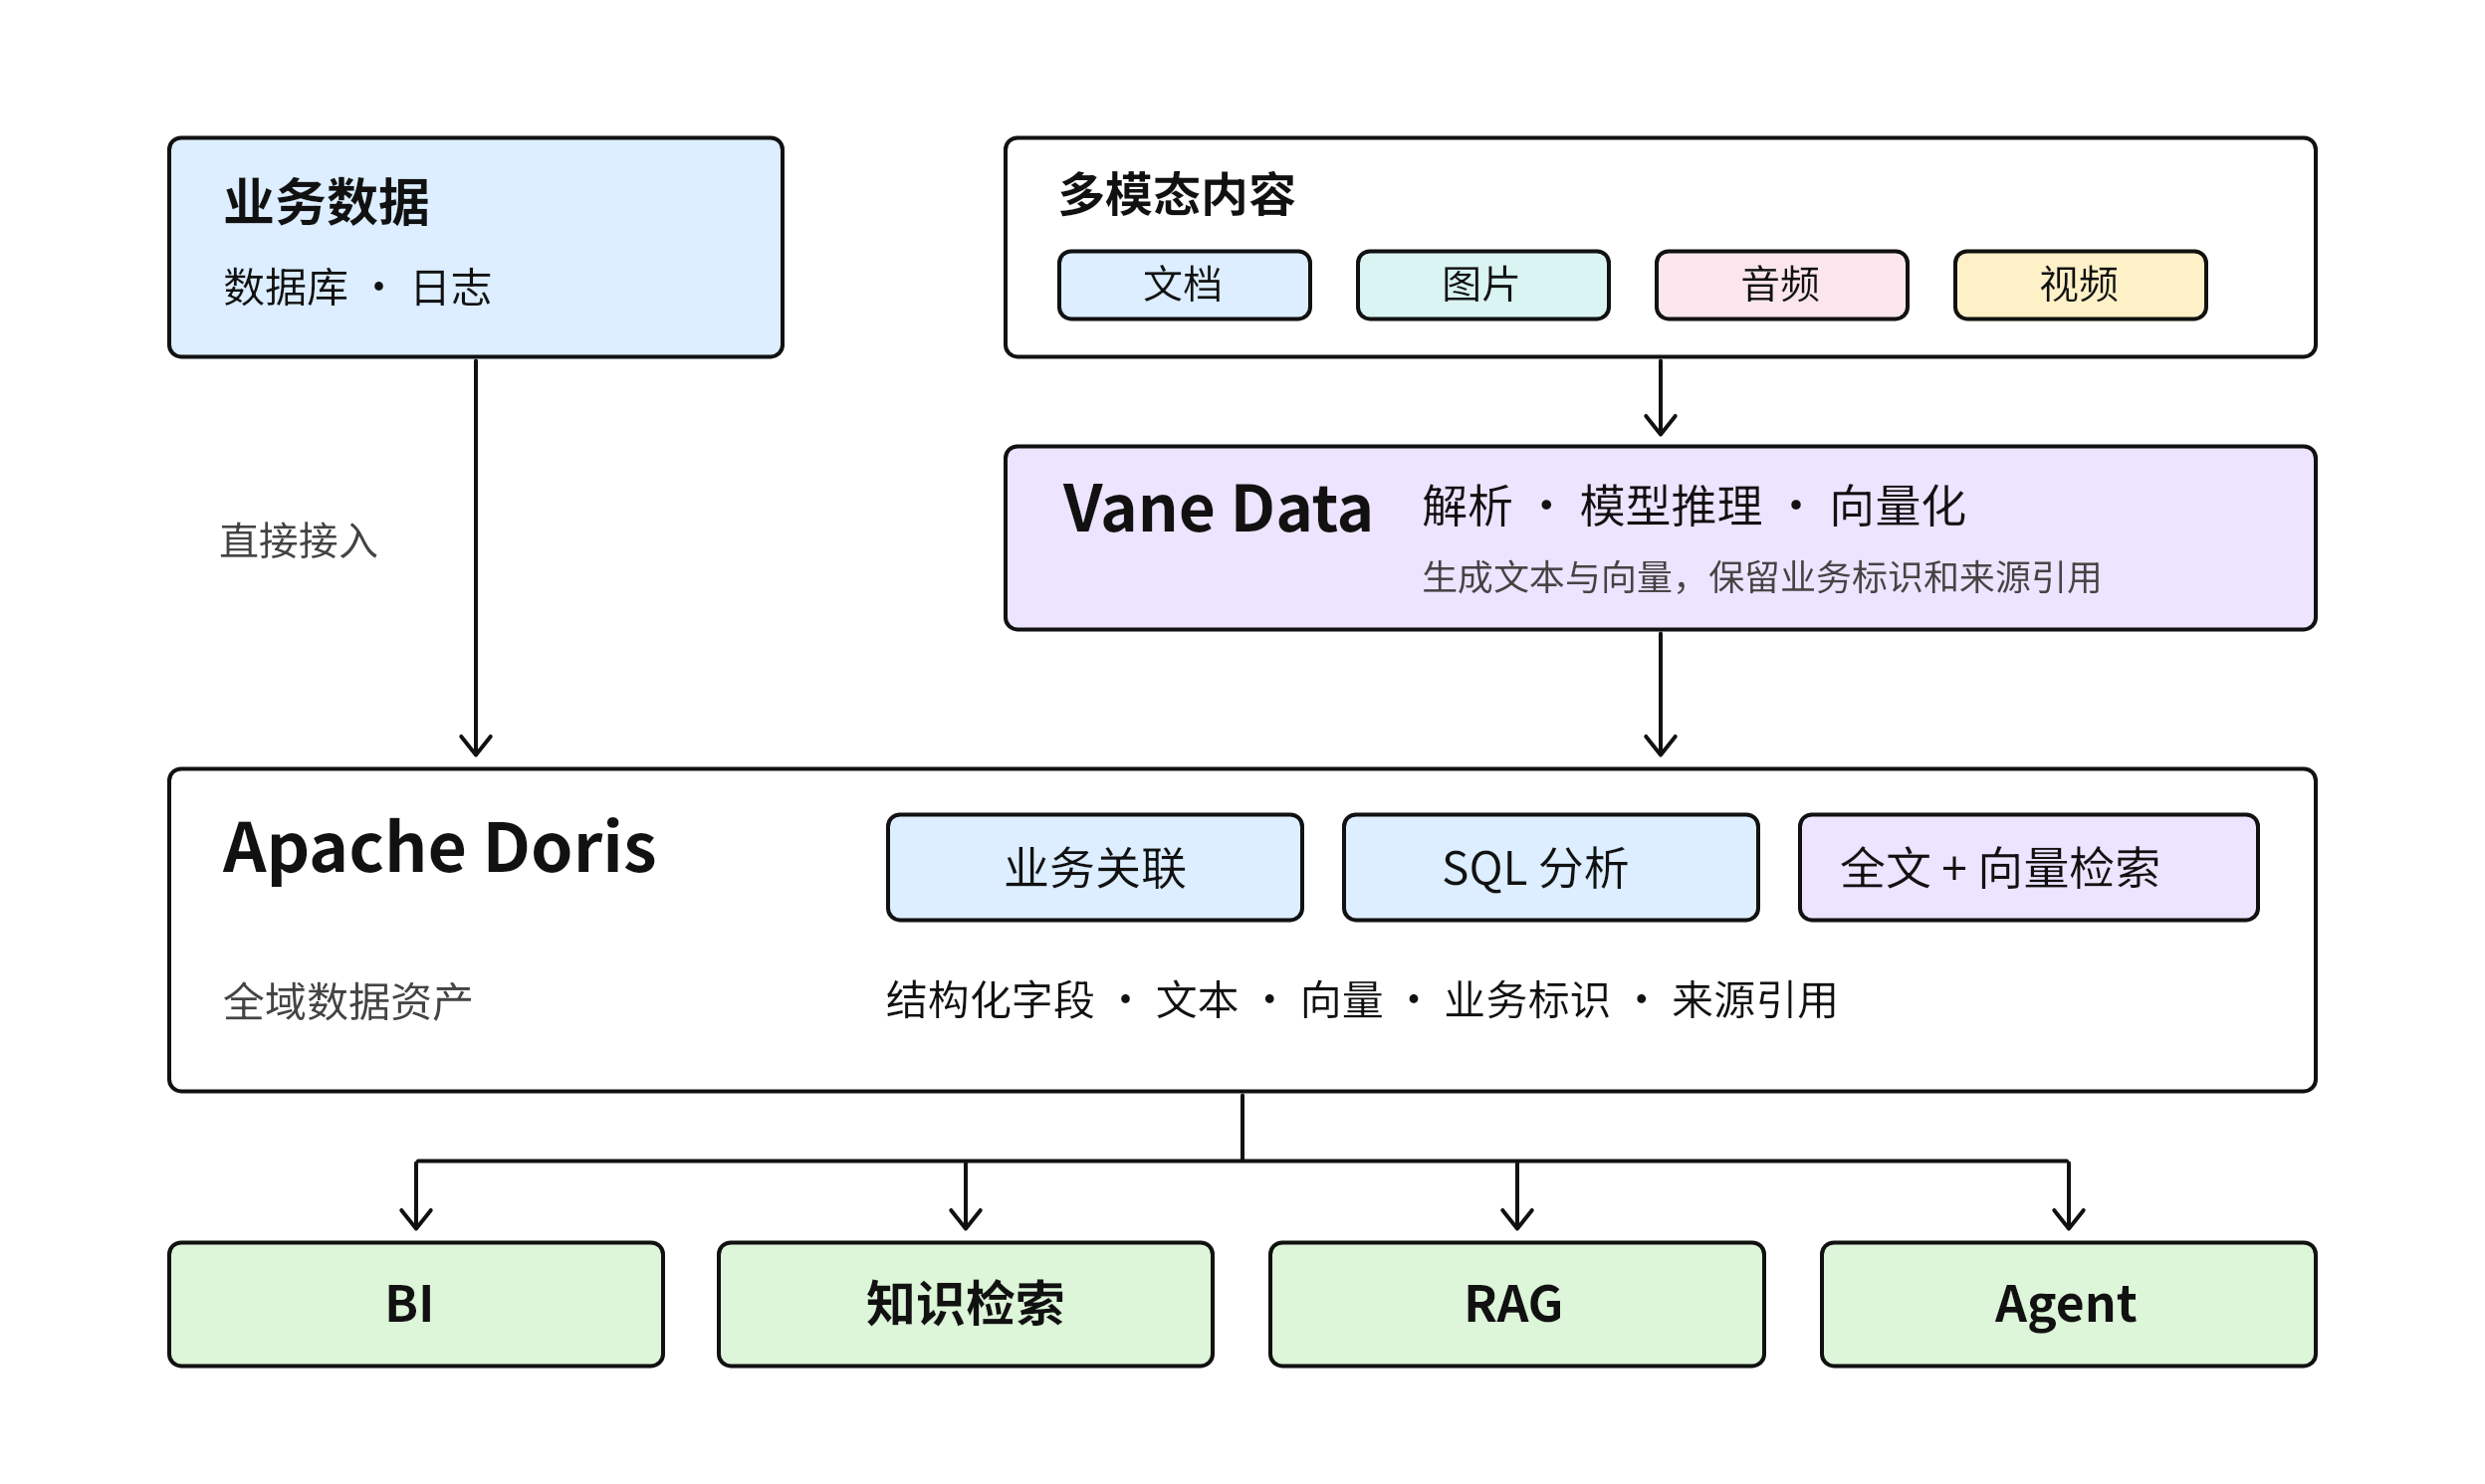
Vane 将 SQL、Python UDF 与 AI Function 组织在同一条数据流中,统一安排执行与数据传递,让业务标识、来源和处理结果在加工过程中保持关联。并通过流水线协调数据读取、解码、模型推理和结果处理,让多模态加工可以稳定、持续地运行。
Vane 将文档、图片、音频和视频处理成文本、结构化字段和向量之后,结果写入 Doris,与订单、工单、客户、生产批次等业务数据汇合。
下面以设备售后录音为例,看看一段录音如何逐步变成可以进入业务查询的数据。代码主要节选自Vane + Doris 客服录音检索教程。
从售后录音到业务分析:Doris + Vane 实践
以下按“Doris 建表 → Vane 加工并写入 → Doris 查询与分析”的顺序展开。
在 Doris 中准备数据表与索引
首先在 Doris SQL 客户端中创建目标表。feedback_segments 按录音片段保存文本、候选分类、384 维向量和来源位置,同时保留工单、型号与日期。文本倒排索引供关键词过滤使用,ANN 索引为后续近似向量检索准备。
Doris SQL | 创建录音片段表与索引:
-- 在 Doris 中执行:创建按录音片段存储的结果表。
CREATE TABLE vane_support_demo.feedback_segments (
    ticket_id VARCHAR(64) NOT NULL,
    segment_id INT NOT NULL,
    -- 型号和日期用于限定业务查询范围。
    product_model VARCHAR(64),
    event_date INT,
    -- 保存转写文本、AI 候选分类和独立的复核状态;入库时状态为 pending。
    text STRING,
    fault_category VARCHAR(64),
    review_status VARCHAR(32),
    -- 原始录音路径与片段起止时间(毫秒),用于检索后回听核查。
    source_uri STRING,
    start_ms BIGINT,
    end_ms BIGINT,
    embedding ARRAY<FLOAT> NOT NULL, -- 与 ai_embed 的 384 维输出对应。
    -- 倒排索引用于文本过滤
    INDEX idx_text(text) USING INVERTED PROPERTIES("parser" = "chinese"),
    -- HNSW 使用 L2 距离;索引维度必须与模型输出、写入配置一致。
    INDEX idx_embedding(embedding) USING ANN PROPERTIES(
        "index_type" = "hnsw", "metric_type" = "l2_distance", "dim" = "384"
    )
) ENGINE=OLAP
DUPLICATE KEY(ticket_id, segment_id)
DISTRIBUTED BY HASH(ticket_id) BUCKETS 1
PROPERTIES("replication_num" = "1");
再准备业务关联表:ticket_orders 记录工单与订单的关系,orders 记录订单所属的生产批次。这里沿用教程的演示数据,假定一个工单对应一个订单、一个订单对应一个批次;实际应用中可对接 Doris 中已有的业务表。
其他业务表的建表语句及演示数据,见教程第 2 节“在 Doris 中创建表和索引”。
用 Vane 将录音加工为可检索的数据
接入录音,关联工单信息
首先,录音和工单信息作为 Pipeline 的输入。Vane 可以直接管理文件引用,并将文件与工单、产品型号等业务元数据放在同一条数据流中:
Vane SQL | 录音与工单接入(节选):
-- 在 Vane 中执行:将文件引用和工单元数据组成同一条记录。
WITH files AS (
    SELECT
        ticket_id,
        product_model,
        event_date,
        -- FILE 保存文件引用,再转换为转写 UDF 接收的 AUDIOFILE。
        audio_file(
            file(f.url, NULL, NULL, NULL, NULL)
        ) AS audio
    -- 枚举录音文件;真正读取音频内容由后续转写步骤完成。
    FROM list_files('./recordings/*.wav') AS f
    -- 工单清单提供型号和日期;ticket_id 应唯一。
    JOIN read_csv('tickets.csv', header = true) AS t
      -- 从 T1024.wav 提取 T1024,与工单 ID 匹配;未匹配文件不会进入结果。
      ON regexp_extract(f.url, '([^/]+)\.wav$', 1) = t.ticket_id
)
SELECT
    ticket_id,
    product_model,
    event_date,
    audio
FROM files;
这里原始文件从一开始就带着业务上下文进入处理链路。后面的转写、抽取和向量化,都可以沿着这条数据流继续处理。
转写录音,保留片段与时间位置
对于录音,转写阶段不仅生成文本,还可以保留片段的时间位置。这样,后续检索到一条反馈时,仍然能够定位回原始录音:
Python UDF | 转写模型(省略转写实现与注册):
# 在 Vane 中定义批处理 UDF。
@vane.cls.batch(actor_number=1, gpus=0, return_dtype="VARCHAR")
class SpeechRecognizer:
    # 每个 Actor 初始化时加载模型,后续批次复用同一实例。
    def __init__(self, model_name):
        from faster_whisper import WhisperModel
        self.model = WhisperModel(
            model_name,
            device="cpu",
            compute_type="int8"
        )


    # 输入为一批 AUDIOFILE;完整实现返回与输入行数一致的 JSON 文本数组。
    def __call__(self, audios):
        # 对一批 AUDIOFILE 进行转写,
        # 同时保留每个片段的起止时间。
        # JSON 中包含片段编号、文本和毫秒级起止时间,后续 SQL 展开为片段行。
        # 此处省略实现与注册,完整代码见教程。
        ...
提取候选故障类别,生成文本向量
转写结果随后可以继续作为 SQL 数据参与处理。例如,从文本中提取候选故障类别:
提示词约束 JSON 字段和类别范围,并要求对证据不足的描述保留不确定性:
Vane SQL | 候选故障分类(节选):
-- 在 Vane 中执行;segments 来自前序转写和片段展开步骤。
SELECT
    ticket_id,
    segment_id,
    text,
    -- 对每个片段提取候选类别,限制 JSON 字段与枚举范围。
    ai_prompt(
        '仅根据下面的售后录音片段提取故障类别。'
        || '只返回 JSON 对象,键为 fault_category;'
        || '值只能是:无法启动、正常咨询、其他故障、待确认。'
        || '不要把否定、假设或维修后已恢复的描述当作已确认故障;'
        || '证据不足填待确认。片段:' || text,
        provider := 'openai',
        model := '...', -- 替换为账号可用的文本模型 ID
        -- 模型调用出错时抛出异常,避免将调用失败当作有效分类。
        on_error := 'raise'
    ) AS fault_json
FROM segments;
分类结果经 JSON 格式校验和类别归一后入库,仍属于待复核的候选标签;校验不通过或类别不在枚举内时归为“待确认”。
同一段文本还可以在 Vane 中生成向量:
Vane SQL | 文本向量化表达式(节选):
-- Vane 中的 SELECT 表达式节选:对转写原文生成语义向量。
ai_embed(
    text,
    -- 使用 Transformers 模型;新查询文本也应使用相同模型和处理方式。
    provider := 'transformers',
    model := 'sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2',
    -- 与 Doris 向量列的写入约束和 ANN 索引 dim 保持一致。
    dimensions := 384,
    -- 对向量做归一化,入库与查询端需保持相同配置。
    options := struct_pack(normalize := true)
) AS embedding
到这里,一段录音已经从一个原始文件变成了一组可以进入 Doris 的字段:文本、候选分类、向量,以及能够定位原始内容的来源和时间位置。
将加工结果写入 Doris
接下来由 Vane 通过 DorisStreamLoadSink 调用 Doris Stream Load,将加工结果写入 Doris。写入代码及连接配置见教程第 3 节“使用 Vane 加工录音并写入 Doris”。
写入内容包括文本、候选分类、审核状态、向量,以及工单标识、原始文件路径和片段起止时间。至此,Vane 完成加工与写入,后续查询在 Doris 中执行。
用 Doris 检索反馈、追溯业务并分析问题分布
下面的 SQL 均在 Doris SQL 客户端中执行。
结合业务条件,检索相似反馈
**检索相似反馈。**先查看工单 T1024 的第一个非空片段,再复用它的向量,在 X1 型号、2026 年 9 月的范围内查找其他工单的相似反馈。查询返回样本文本,便于判断比较的内容是否符合预期。
Doris SQL | 按业务条件检索相似片段:
-- 先检查作为查询样本的片段;下方检索使用相同的选择条件。
SELECT ticket_id, segment_id, text
FROM vane_support_demo.feedback_segments
WHERE ticket_id = 'T1024'
  AND length(trim(text)) > 0
ORDER BY segment_id
LIMIT 1;


-- 以 T1024 的第一个非空片段为样本,寻找其他工单的相似反馈。
-- LIMIT 1 使查询样本最多一行;直接复用已有向量,无需再次调用模型。
WITH query_feedback AS (
    SELECT ticket_id, segment_id, text, embedding
    FROM vane_support_demo.feedback_segments
    WHERE ticket_id = 'T1024'
      AND length(trim(text)) > 0
    ORDER BY segment_id
    LIMIT 1
)
-- 同时返回样本文本和候选文本,便于核查实际比较的内容。
SELECT q.ticket_id AS query_ticket_id,
       q.segment_id AS query_segment_id,
       q.text AS query_text,
       f.ticket_id, f.segment_id, f.text, f.fault_category,
       f.source_uri, f.start_ms, f.end_ms,
       -- 比较候选向量与样本向量,L2 距离越小越相似。
       l2_distance_approximate(f.embedding, q.embedding) AS distance
FROM vane_support_demo.feedback_segments f
CROSS JOIN query_feedback q
-- 仅在指定型号和日期范围内寻找相似反馈。
WHERE f.product_model = 'X1'
  AND f.event_date >= 20260901 AND f.event_date < 20261001
  -- 排除样本工单的全部片段,避免把自身反馈作为相似案例。
  AND f.ticket_id <> q.ticket_id
-- 优先按距离排序;距离相同时按工单和片段编号排序。
ORDER BY distance ASC, f.ticket_id, f.segment_id
-- 最多返回 3 个片段,同一工单可出现多次;相似度不代表故障已确认。
LIMIT 3;
距离越小表示向量越接近;查询最多返回 3 个片段,同一工单可能出现多个片段。若还要求原文包含“指示灯”,可在检索 SQL 的 WHERE 条件末尾、ORDER BY 之前增加 AND f.text MATCH_ANY '指示灯',组合文本匹配与向量排序。
关联订单与生产批次,追溯反馈来源
**关联订单与生产批次。**查询从录音片段表出发,通过工单关联订单,再找到对应的生产批次。使用 LEFT JOIN 保留尚未匹配到业务关系的反馈,方便检查数据完整性。
Doris SQL | 关联订单与生产批次:
-- 将录音片段关联到订单和生产批次;保留未匹配的记录以便检查。
SELECT f.ticket_id, f.segment_id, f.text, f.fault_category,
       t.order_id, o.production_batch,
       -- 保留原始录音位置,便于从业务记录回到证据片段。
       f.source_uri, f.start_ms, f.end_ms
FROM vane_support_demo.feedback_segments f
-- 通过工单 ID 找到订单;LEFT JOIN 保留未匹配记录,相应字段为 NULL。
LEFT JOIN vane_support_demo.ticket_orders t ON f.ticket_id = t.ticket_id
-- 再通过订单 ID 找到生产批次;教程假定一个订单对应一个批次。
LEFT JOIN vane_support_demo.orders o ON t.order_id = o.order_id
-- 查询指定业务范围内的所有片段
WHERE f.product_model = 'X1'
  AND f.event_date >= 20260901 AND f.event_date < 20261001
ORDER BY f.ticket_id, f.segment_id;
按演示数据,T1024 和 T1025 分别关联 O9001、O9002,均属于 B202608;T1026 关联 O9003,属于 B202609。这些关系来自业务表。查询同时保留原始文件路径和毫秒级时间位置,供回听核查;source_uri 是来源路径。
按批次汇总候选工单,辅助质量排查
**按生产批次分析候选工单分布。**下面从整张片段表中筛选 X1 型号在 2026 年 9 月被 AI 分类为“无法启动”的记录,按工单去重后关联批次并计数。统计范围独立于前面的 Top-3 检索结果,用于为人工排查提供批次维度的线索。
Doris SQL | 按批次统计候选工单数:
-- 统计:按批次汇总 AI 分类为“无法启动”的候选工单。
WITH candidate_tickets AS (
    -- 一个工单可有多个命中片段,先去重为工单集合。
    SELECT DISTINCT ticket_id
    FROM vane_support_demo.feedback_segments
    WHERE product_model = 'X1'
      AND event_date >= 20260901 AND event_date < 20261001
      -- 至少一个片段被 AI 标为“无法启动”即进入候选集,不要求已人工确认。
      AND fault_category = '无法启动'
)
-- 未找到批次的工单单独成组,避免在统计中悄悄丢失。
SELECT COALESCE(o.production_batch, '未关联到批次') AS production_batch,
       -- 按工单 ID 去重计数,统计的是候选工单数,不是片段数或故障率。
       COUNT(DISTINCT f.ticket_id) AS candidate_ticket_count
FROM candidate_tickets f
-- 沿“工单 → 订单 → 生产批次”的业务关系补齐统计维度。
LEFT JOIN vane_support_demo.ticket_orders t ON f.ticket_id = t.ticket_id
LEFT JOIN vane_support_demo.orders o ON t.order_id = o.order_id
-- 按批次汇总,优先展示候选工单较多的批次,供后续人工排查。
GROUP BY COALESCE(o.production_batch, '未关联到批次')
ORDER BY candidate_ticket_count DESC, production_batch;
candidate_ticket_count 表示至少有一个片段被 AI 分类为“无法启动”的候选工单数;没有该类别时返回空集。
这条链路中,Vane 将录音加工成可入库的数据,Doris 将加工结果与工单、订单和生产批次连接起来。从相似反馈检索,到业务关系追溯,再到按批次汇总候选问题,多模态信息由此进入同一套 SQL 查询与分析流程。
某制造企业 Doris + Vane 场景实践
某制造企业以 Doris 作为统一实时数据分析底座,汇集生产、质检、设备与售后数据,支撑产线监控、良率分析、批次追溯和故障统计等场景。随着 AI 需求深入业务,企业需要进一步将图片、文档和录音纳入现有数据体系。**Doris 在已有实时分析能力之上,引入全文与向量检索能力,进一步承载企业 AI 场景中的多模态数据检索与分析。**同时结合 Vane 作为多模态数据加工引擎,实现多个 AI 场景的落地。
- 工艺异常分析:让良率波动关联历史改善经验
企业在 Doris 中汇集了工艺参数、测试结果、设备状态及批次信息,实时分析良率趋势,并按工序、设备和班次下钻。当某工序良率下降时,工程师还需要查阅历史异常报告、8D 报告和试验记录,寻找类似问题及有效的改善措施。
使用 Vane 解析这些文档,提取异常现象、参数条件、改善措施与验证结论,生成文本向量,并保留业务标识、文档版本和页码。加工结果写入 Doris 后,可结合产品、工序等条件,通过关键词与向量混合检索查找相似案例,再关联当前批次的参数分布、历史试验和改善前后指标。
由此,实时分析发现的异常可以直接连接历史处理经验。AI 根据业务数据与文档证据提出排查建议,工程师通过试验验证原因和措施,减少跨系统查资料、核对参数的工作,缩短异常排查过程。
- 售后质量分析:让客户描述关联产品运行与制造数据
企业利用 Doris 分析售后工单、产品故障码、运行记录和生产批次,开展故障统计与产品追溯。随着 AI 深入售后业务,录音、文字和照片中的客户描述也需要参与分析:例如“充不进去电”和“充电到一半就停”,需要结合实际运行情况判断是否属于同类问题。
使用 Vane 转写录音、解析附件,提取故障现象和候选类别,生成向量,并保留工单号、原图或录音时间位置。Doris 结合型号、时间和故障关键词开展混合检索,再将相似反馈与产品运行记录、维修结果及生产批次关联,按工单或产品去重统计问题分布。
客户反馈由此进入已有的质量分析体系。业务人员既能回看原始证据,也能判断相似问题是否集中于特定批次或运行条件,帮助更早发现集中性质量问题,缩短从客户描述到生产追溯和影响范围排查的路径。
总结
多模态 AI 的价值,不只是把录音、图片和视频“搜出来”,而是让其中的信息能够与客户、订单、工单和生产批次关联起来,进一步参与业务分析。
**Vane 让原始内容变得可计算,Doris 让这些内容进入业务。**从一个具体场景开始,把一类多模态数据接入现有数据体系,就可以逐步建立从内容理解、语义检索到业务分析的完整链路。
与其让更多数据继续留在文件里,不如先让它成为可以被检索、关联和分析的数据。欢迎从一类真实数据开始,探索 Doris 与 Vane 的组合。你可以跟随客服录音检索教程复现本文场景,阅读上手指南,访问 Vane GitHub,分享你的场景与反馈。